Was sind Workflows – und warum jetzt?
▼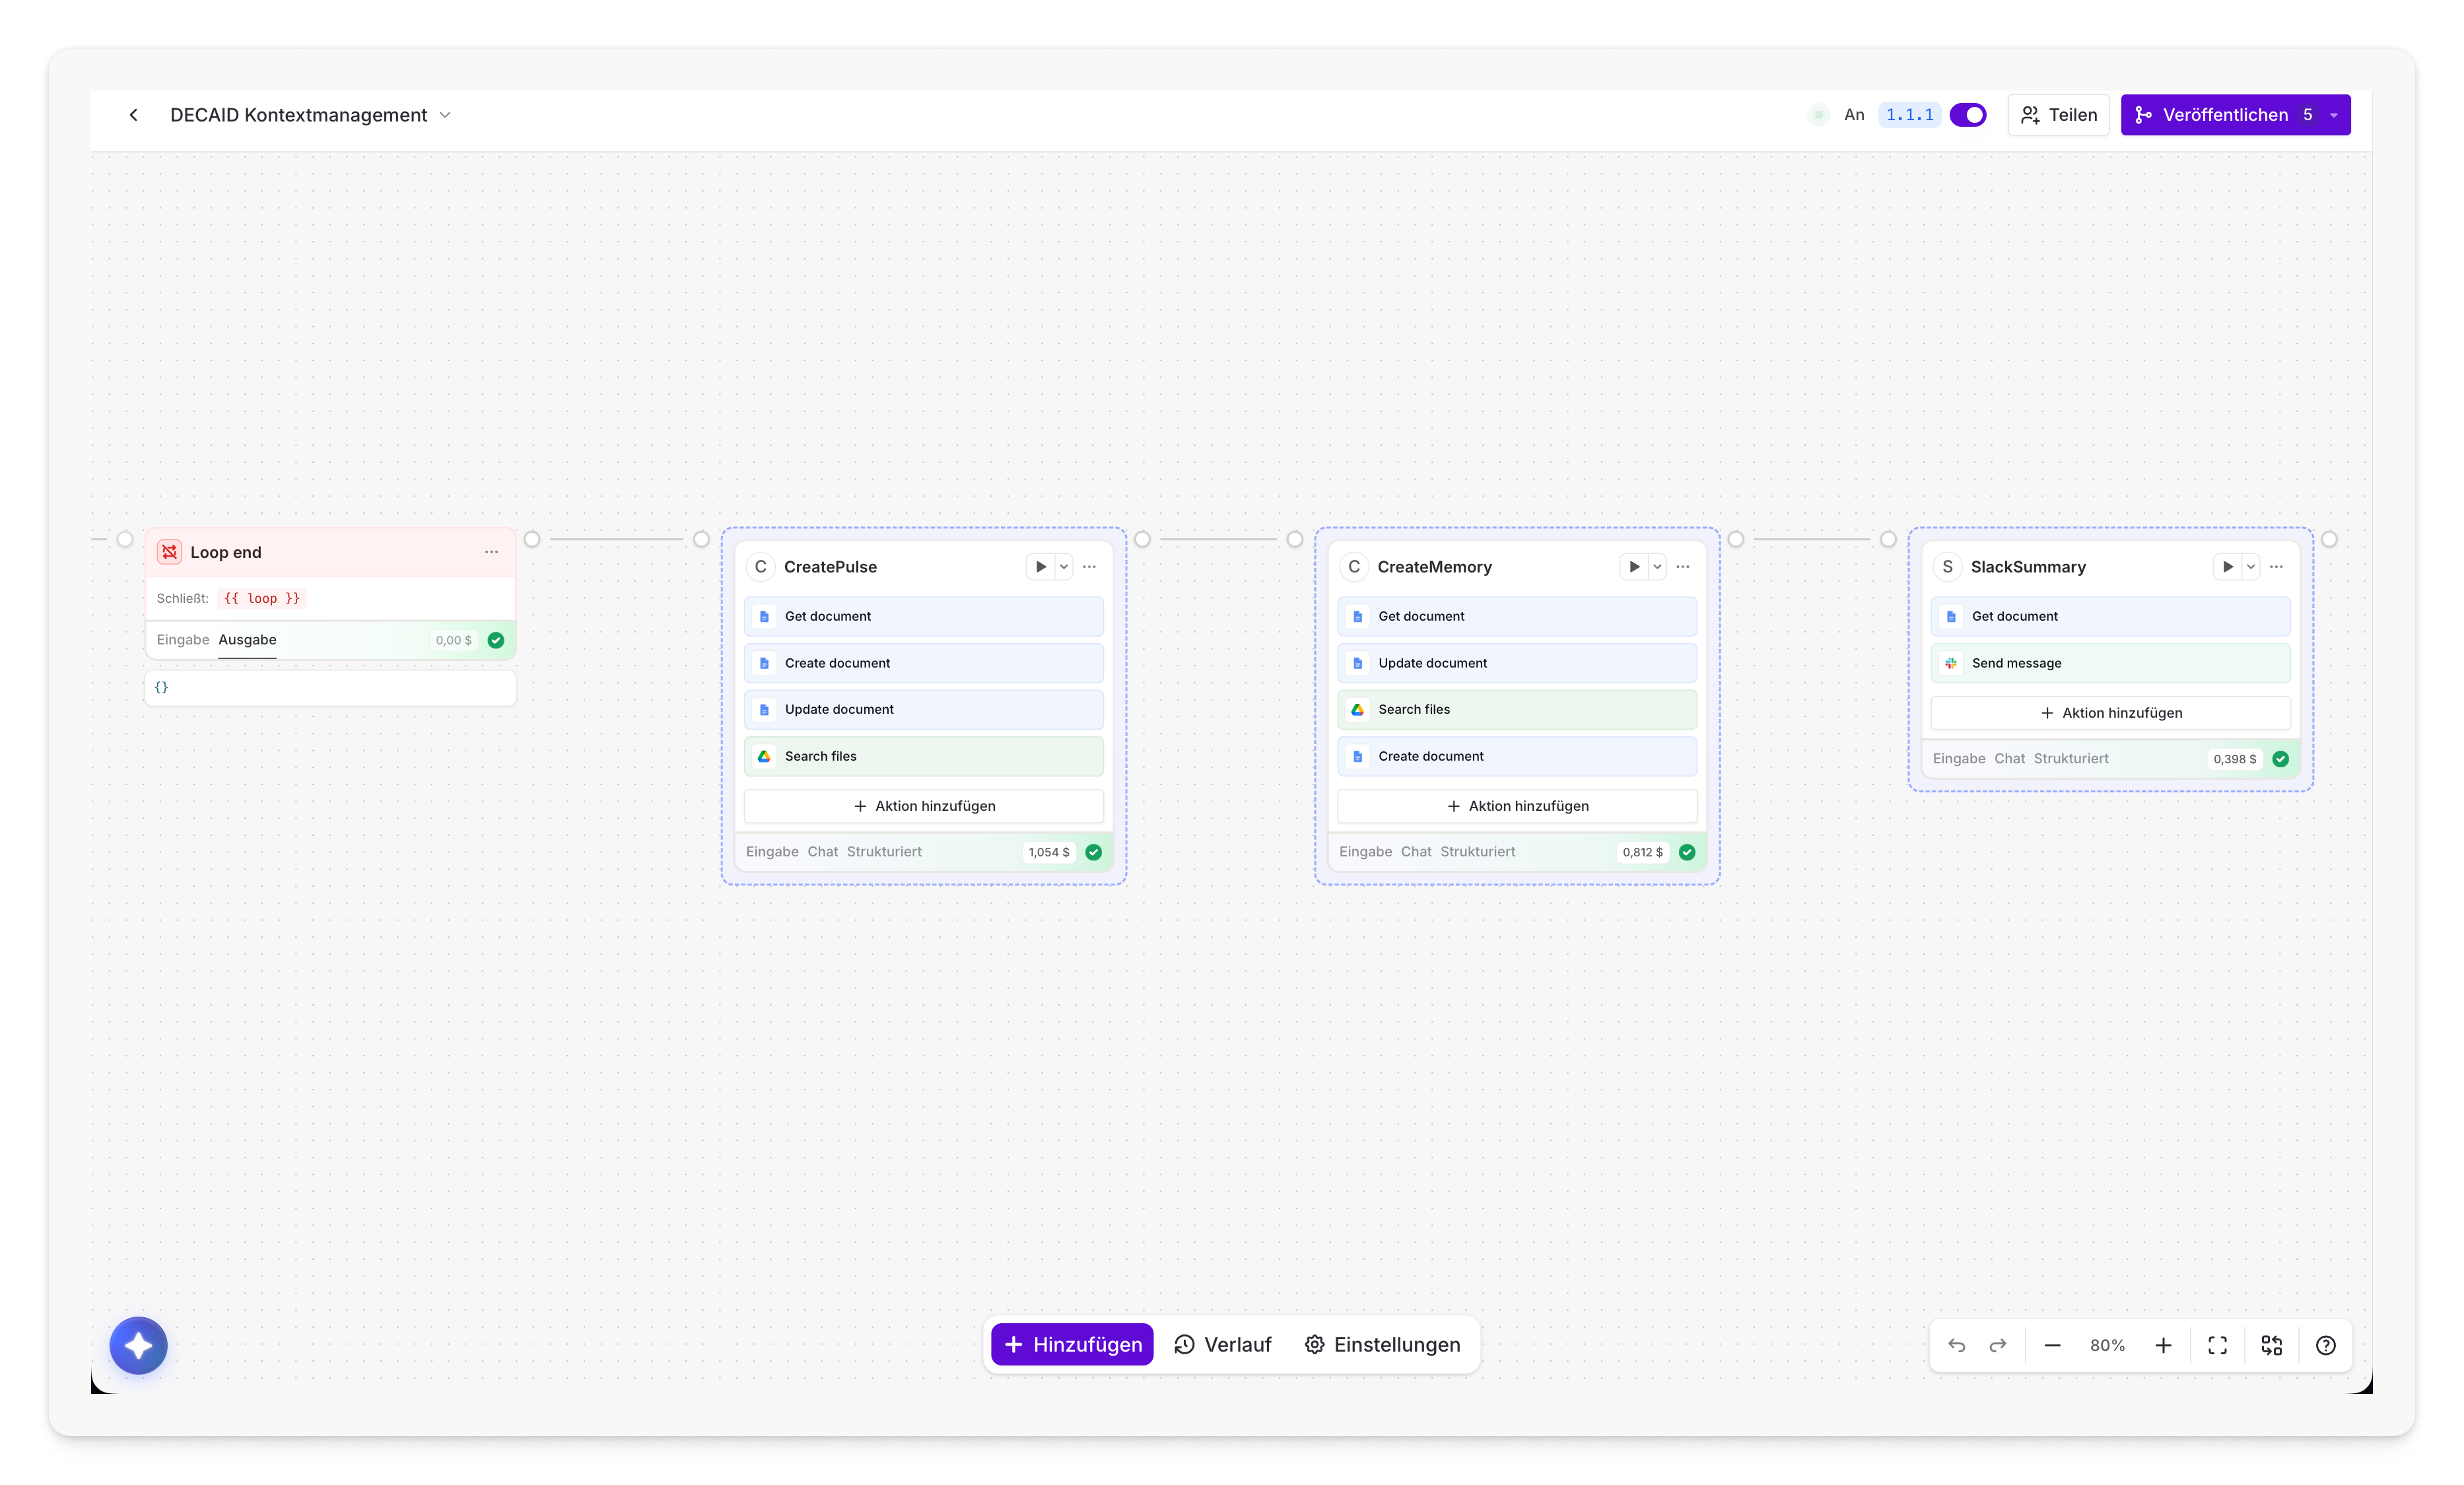
So sehen Workflows in Langdock aus: Nodes auf einer visuellen Canvas verbinden – ohne Code.
Die Evolution: Chat → Agenten → Workflows
Du kennst Langdock bereits aus dem Chat und hast vielleicht schon eigene Agenten gebaut. Workflows sind der nächste logische Schritt: Statt manuell mit KI zu interagieren, automatisierst du komplette Prozesse von Anfang bis Ende.
Der Unterschied in einem Satz:
- Chat = Du fragst, KI antwortet (1:1 Dialog)
- Agenten = KI mit Spezialwissen und Kontext (konfigurierter Assistent)
- Workflows = Mehrere Schritte laufen automatisch ab – mit KI, Logik und Integrationen (End-to-End-Automation)
Wann lohnen sich Workflows?
Workflows sind dann sinnvoll, wenn du einen Prozess hast, der:
- Wiederkehrend ist (z.B. jeden Tag, jede Woche, bei jedem neuen Lead)
- Mehrere Schritte umfasst (Daten empfangen → analysieren → weiterleiten → dokumentieren)
- Keine menschliche Kreativität im Kern braucht (Routing, Kategorisierung, Standardkommunikation)
- Fehleranfällig ist, wenn manuell ausgeführt (vergessene Follow-ups, inkonsistente Kategorisierung)
Was Workflows NICHT ersetzen
Workflows sind kein Ersatz für kreative Arbeit, strategische Entscheidungen oder komplexe Einzelfallbearbeitung. Sie übernehmen die repetitive Vorarbeit, damit dein Team sich auf das Wesentliche konzentrieren kann.
Architektur verstehen: Die Bausteine
▼Was ist ein Node?
Ein Node (Knoten) ist ein einzelner Schritt in deinem Workflow – vergleichbar mit einem Baustein. Jeder Node hat genau eine Aufgabe: Daten empfangen, KI etwas analysieren lassen, eine Bedingung prüfen, eine E-Mail senden, und so weiter.
Nodes werden auf einer visuellen Canvas (Arbeitsfläche) per Drag & Drop platziert und miteinander verbunden. Keine Programmierung nötig – es sei denn, du willst den Code-Node nutzen.
Anatomie eines Nodes
Jeder Node hat:
- Header: Zeigt Typ und Name. Hier findest du auch den Play-Button zum Testen.
- Input-Tab: Zeigt, welche Daten der Node empfangen hat (nach einem Test-Run).
- Output-Tab: Zeigt, welche Daten der Node produziert hat.
- Konfigurationspanel: Öffnet sich per Klick – hier stellst du alles ein.
Connections: Wie Daten fließen
Die Linien zwischen Nodes sind mehr als nur Dekoration: Sie bestimmen die Ausführungsreihenfolge und den Datenfluss.
- Links (Eingang): Woher die Ausführung kommt
- Rechts (Ausgang): Wohin die Ausführung weitergeht
- Mehrere Ausgänge: Condition-Nodes haben einen Ausgang pro Bedingung
- Roter Ausgang: Spezieller Error-Pfad (wenn aktiviert)
Ausführungsmodelle
Sequenziell (Standard): Nodes laufen nacheinander ab. Node B wartet, bis Node A fertig ist.
Parallel: Wenn mehrere Nodes an einen einzelnen Ausgang angeschlossen sind, laufen sie gleichzeitig. Das beschleunigt deinen Workflow, wenn die Schritte voneinander unabhängig sind.
                → E-Mail senden →
Trigger →       → Ticket erstellen →      → Weiter
                → Datenbank aktualisieren →
Error Handling
Für jeden Node kannst du individuell festlegen, was bei einem Fehler passiert:
- Workflow stoppen (Fail): Der gesamte Workflow wird als fehlgeschlagen markiert. Sinnvoll für kritische Schritte.
- Workflow fortsetzen (Continue): Der Fehler wird protokolliert, aber der Workflow läuft weiter. Sinnvoll für optionale Schritte.
- Error Callback: Die Ausführung wird über den roten Error-Ausgang an andere Nodes umgeleitet. Sinnvoll für Fallback-Logik.
Nodes deaktivieren
Einzelne Nodes können temporär deaktiviert werden, ohne sie zu löschen. Deaktivierte Nodes werden bei der Ausführung übersprungen – ideal zum Debuggen oder für optionale Schritte, die du vorübergehend ausschalten willst. Per Rechtsklick auf den Node oder über das Node-Menü kannst du den Status umschalten.
Nodes kommentieren
Komplexe Logik lässt sich direkt auf der Canvas dokumentieren: Über das Drei-Punkte-Menü eines Nodes findest du Add Comment. Der Kommentar hängt am Node und erklärt späteren Bearbeitern, warum ein Schwellenwert genau so gewählt ist oder welcher Sonderfall hier abgefangen wird. Das ist die billigste Form von Wartbarkeit, die ein Workflow haben kann.
Replay events: mit echten Daten testen
Testdaten von Hand einzutippen ist fehleranfällig, weil die erfundenen Werte nie so aussehen wie die echten. Im Test-Run-Panel gibt es deshalb Replay events: Du wählst ein zurückliegendes Ereignis aus, also eine echte Formular-Einreichung, einen echten Webhook-Request oder ein echtes Integration-Event, und lässt den Workflow damit laufen.
Testläufe behalten ihren Kontext seit September 2026: Seit dem 18.09.2026 merkt sich ein Testlauf die Ergebnisse der Nodes, die schon gelaufen sind. Passt du einen Node weiter hinten an und testest erneut, stehen die früheren Outputs weiter bereit, du musst den Trigger also nicht jedes Mal neu auslösen. Dazu sind die Output-Werte eines Nodes übersichtlicher dargestellt, was das Finden der richtigen Felder für die nächsten Nodes erleichtert.
Workflows als Bausteine: ein Workflow ruft den nächsten seit September 2026
Seit dem 18.09.2026 (»Composable Workflows«) kann ein Workflow einen anderen Workflow aufrufen, auf dessen Ergebnis warten und mit diesem Output weiterlaufen. Im Editor wählst du den aufzurufenden Workflow aus und ordnest seine Eingaben zu, ähnlich wie bei einer Action.
- Maximal fünf Ebenen tief: Ein aufgerufener Workflow darf selbst wieder einen aufrufen, insgesamt aber höchstens fünf Ebenen.
- Zyklus-Erkennung: Ruft A den Workflow B und B wieder A, erkennt Langdock den Kreislauf und verhindert ihn.
- Nachvollziehbar in der Run-Historie: Verschachtelte Läufe tragen die Hinweise Called by und Open Child Run. Ein Fehler in der dritten Ebene lässt sich so bis zum auslösenden Lauf zurückverfolgen.
Workflow Builder Chat
Statt jeden Node manuell zu platzieren, kannst du Workflows auch per natürlichsprachlicher Beschreibung erstellen lassen. Der Workflow Builder Chat (Button unten links im Builder) generiert aus deiner Beschreibung einen kompletten Workflow.
- Workflows beschreiben: „Erstelle einen Workflow, der jeden Montag einen Report aus Google Sheets generiert und per Slack versendet.“
- Fix in Chat: Bei Fehlern erscheint ein Button, der die Fehlerdetails automatisch an den Chat übergibt – die KI analysiert das Problem und schlägt Korrekturen vor.
- Preferences: Über das Einstellungen-Panel kannst du bevorzugte Tools (E-Mail, CRM, Ticketing) und Custom Instructions hinterlegen.
- Rückfragen statt Raten: Ist deine Beschreibung zu unscharf, stellt der Builder zuerst ein paar Klärungsfragen und bietet Antwortvorschläge an, aus denen du wählen kannst.
- Chat History: Über das Chat-History-Icon oben rechts kommst du zu früheren Unterhaltungen zurück und setzt sie genau dort fort, wo du aufgehört hast.
- Canvas bleibt aufgeräumt: Chat-Edits erhalten dein Layout. Neue Nodes erscheinen direkt neben dem Node, an den sie andocken, bestehende Nodes bleiben liegen. Willst du alles neu sortieren, nutze den Auto Reorder-Button auf der Canvas oder bitte den Builder darum.
Workflows exportieren und importieren seit August 2026
Jeder Workflow lässt sich als .json-Datei sichern und später wieder einspielen – der saubere Weg, um einen Workflow an Kolleginnen und Kollegen weiterzugeben oder in einen anderen Workspace zu heben.
- Export: Drei-Punkte-Menü neben dem Workflow-Namen → Export workflow (.json).
- Import: Im selben Menü Import workflow (.json). Achtung: Der Import ersetzt die aktuelle Canvas. Langdock fragt vorher nach einer Bestätigung, gespeichert wird erst danach.
- Nur Langdock-Exporte: Dieser Import akzeptiert ausschließlich Dateien, die aus Langdock exportiert wurden. Erkennt Langdock ein fremdes Format, leitet es dich automatisch in den Workflow Builder Chat weiter.
Workflows aus anderen Tools übernehmen
Workflows aus n8n, Zapier oder Make musst du nicht von Hand nachbauen. Exportiere den Workflow dort als JSON und lade die Datei über den Import from-Button im Chat-Panel hoch, oder füge das JSON direkt in den Chat ein. Der Workflow Builder liest die Struktur und baut sie als Langdock-Workflow nach. Seit dem 18.09.2026 ist der Import aus Zapier und Make überarbeitet: Er hat einen klareren Einstieg, und scheitert er, nennt die Fehlermeldung genauer, welcher Teil der Datei nicht zum erwarteten Schema passt.
Trigger-Typen: Wie Workflows starten
▼Jeder Workflow braucht einen Startpunkt – den Trigger. Er bestimmt, wann und wodurch dein Workflow ausgelöst wird.
Übersicht der Trigger-Typen
| Trigger | Auslöser | Typischer Einsatz |
|---|---|---|
| Manual | Button-Klick | Testen, Ad-hoc-Aufgaben |
| Form | Formular-Eingabe | Feedback, Anfragen, Bewerbungen |
| Webhook | HTTP POST oder GET | Externe Systeme, APIs, GitHub |
| Scheduled | Zeitplan (Cron) | Tägliche Reports, Daten-Sync |
| Integration | Event in App | Slack-Nachricht, neue Sheets-Zeile |
| Aus Chat/Agent | @-Menü im Chat | On-Demand-Automatisierung aus Konversationen |
Mehrere Trigger pro Workflow seit September 2026: Seit dem 18.09.2026 ist ein Workflow nicht mehr auf einen einzigen Startpunkt festgelegt. Du kannst mehrere Trigger an denselben Ablauf hängen, etwa einen Integration Trigger für den Regelbetrieb und zusätzlich einen Manual Trigger oder ein Formular für Nachzügler. Das erspart es, denselben Ablauf zweimal zu bauen und doppelt zu pflegen. Einzelne Doku-Seiten sprechen noch von »genau einem Trigger«, maßgeblich ist hier der Changelog.
Manual Trigger
Der einfachste Trigger: Ein Klick startet den Workflow. Perfekt zum Entwickeln und Testen. Jeder neue Workflow sollte zunächst mit einem Manual Trigger gebaut und getestet werden, bevor du auf einen automatischen Trigger umstellst.
Form Trigger
Erstellt ein Webformular, das den Workflow bei Absendung startet. Ideal für die Datenerfassung von internen oder externen Nutzern.
Verfügbare Feldtypen:
- Text (einzeilig), Long Text (mehrzeilig)
- E-Mail, Telefon, Nummer
- Datum, Dropdown, Checkbox
- Datei-Upload
Wichtige Einstellungen:
- Formulartitel und Beschreibung definieren
- Felder als Pflichtfelder markieren
- „Thank You“-Nachricht konfigurieren
- Öffentlichen Zugang aktivieren (für externe Nutzer)
- iframe-Einbettung (seit März 2026): Workflow-Formulare können per
<iframe>in externe Webseiten, Intranets oder Portale eingebettet werden – Nutzer müssen Langdock nicht verlassen. - Allowed email domains: Bei Feldern vom Typ E-Mail kannst du eine oder mehrere erlaubte Domains hinterlegen (kommagetrennt). Eingaben von anderen Domains weist das Formular ab. Der saubere Weg, ein öffentlich erreichbares Formular trotzdem auf Kunden oder auf die eigene Belegschaft zu begrenzen, ohne davor eine Anmeldung zu bauen.
Webhook Trigger
Stellt eine eindeutige URL bereit, die externe Systeme per HTTP POST aufrufen können. Der ideale Trigger, wenn du Langdock mit eigenen Anwendungen, GitHub, Stripe oder anderen Services verbinden willst. Seit dem 18.09.2026 nimmt der Webhook Trigger auch GET-Anfragen an, die Authentifizierung bleibt dabei optional. Damit taugt die URL auch als Start-Link hinter einem Button, in einer Slack-Nachricht oder im Intranet. Genau deshalb gehört ein solcher Link nicht ohne Secret in Umlauf: Wer die URL kennt, startet den Workflow.
Auth-Modi (drei Varianten):
- No Auth: URL ist öffentlich zugänglich. Nur für Tests oder bewusst öffentliche Endpoints.
- Query-Parameter: Token wird als URL-Parameter mitgeschickt (z.B.
?secret=xyz). Sichtbar in Logs, nur für interne Setups geeignet. - X-Webhook-Secret Header (empfohlen): Token im HTTP-Header. Wird nicht in Logs/Referrern geleakt, der saubere Weg für Produktion.
Sobald du eine Auth-Methode wählst, generiert Langdock automatisch ein Secret. Das Secret bleibt erhalten, wenn du zwischen Header und Query-Parameter wechselst – du verlierst deinen Schlüssel also nicht versehentlich. Lässt du das Feld bei aktiver Auth-Methode leer, warnt dich die Validierung. Bestehende Webhooks mit Query-Parameter laufen unverändert weiter: Ist das Feld nicht gesetzt, bleibt das alte Verhalten aktiv.
Advanced options: Signature-Header und Roh-Body
Unter Advanced options liegen zwei Schalter, die beide standardmäßig aus sind. Sie brauchst du immer dann, wenn ein späterer Node die Echtheit des Requests prüfen soll:
- Include signature headers: Legt den Content-Type und die unterstützten Signature-Header unter
trigger.output.headersab. Unterstützt werden die Signaturen von Stripe, GitHub, Slack, DocuSign, Shopify, Svix und Standard Webhooks. Alle übrigen eingehenden Header bleiben weiterhin draußen. - Preserve raw request body: Hält den ursprünglichen, ungeparsten Body als String unter
trigger.output.rawBodybereit. Das Parsen läuft trotzdem weiter, du hast also beide Fassungen. Weil beide Fassungen gehalten werden, sinkt das Limit für solche Requests auf 12 MB.
Beide Felder erscheinen nur, wenn der jeweilige Schalter für diesen Webhook-Trigger an ist. Für eine echte Signaturprüfung brauchst du in der Regel beide: Der Code Node liest die Signatur aus trigger.output.headers und rechnet sie gegen den unveränderten Body aus trigger.output.rawBody. Nur der Roh-Body ergibt denselben Hash wie beim Absender, ein neu serialisiertes JSON tut das nicht.
Dateien per Webhook übergeben
Ein Webhook kann Dateien direkt im JSON-Body mitbringen: einzelne Dateien unter file, mehrere unter files (maximal 20). Beide Keys funktionieren auf oberster Ebene und in verschachtelten Objekten. Jedes Datei-Objekt braucht fileName, mimeType und genau ein Inhaltsfeld: base64 für Binärdateien wie XLSX, text für Textdateien.
Limit: Der gesamte JSON-Body muss unter 25 MB bleiben, Base64-Inhalte eingerechnet. Base64 bläht Dateien um rund ein Drittel auf, kalkuliere das ein.
Die verarbeiteten Dateien ersetzen im Body die ursprünglichen Objekte. Zugriff:
{{trigger.output.body.files[0].path}}
{{trigger.output.body.files[0]._metadata.name}}
{{trigger.output.body.files[0]._metadata.mimeType}}

{{trigger.output.body.file.path}}   <-- bei Einzeldatei unter "file"
Response-Codes
| Code | Bedeutung | Wann |
|---|---|---|
202 | Accepted | Workflow wurde erfolgreich eingereiht |
400 | Bad Request | Ungültige Workflow-ID, ungültiges Format oder falsches Secret |
404 | Not Found | Workflow nicht gefunden |
413 | Payload Too Large | Roh-Body über 12 MB oder kombinierter Output über 25 MB |
429 | Too Many Requests | Rate Limit oder Spend Limit erreicht |
500 | Server Error | Interner Fehler bei der Webhook-Verarbeitung |
Baue diese Codes in das aufrufende System ein: Ein 429 bedeutet nicht „kaputt“, sondern „zu viel oder Budget aus“ und gehört mit Backoff behandelt.
Scheduled Trigger
Führt den Workflow automatisch zu festgelegten Zeiten aus. Perfekt für wiederkehrende Aufgaben.
Zeitplan-Optionen:
- Alle X Minuten
- Stündlich / Täglich / Wöchentlich / Monatlich
- Benutzerdefinierter Cron-Ausdruck
- Zeitzone konfigurierbar
Beispiele:
- Täglicher Sales-Report um 9:00 Uhr
- Stündlicher Daten-Sync mit externem System
- Wöchentliche Cleanup-Aufgabe sonntags
Integration Trigger
Reagiert auf Events in verbundenen Apps: Neue Slack-Nachricht, neue E-Mail in Gmail, neue Datei in Google Drive, neuer Lead in Salesforce, Kalender-Event und mehr.
Unterstützte Integrationen (Auswahl):
- Kommunikation: Slack (Nachrichten, Reaktionen), Microsoft Teams (Nachrichten, Mentions, Transkripte), Gmail, Outlook
- Produktivität: Notion, Jira, Confluence, GitHub (Pull Requests, Commits, Releases), Microsoft Planner
- Speicher & Finanzen: Google Drive, OneDrive, Dropbox, Stripe (Zahlungen, Abos, Rechnungen)
- CRM: Salesforce (Leads, Kontakte, Opportunities), HubSpot (Deals, Formular-Eingaben, Notizen)
- Kalender: Google Calendar, Outlook Calendar, Calendly
- Weitere: Ashby (Recruiting-Events), Microsoft Power BI
Konfiguration in drei Schritten:
- Integration auswählen
- Event-Typ wählen (z.B. „Neue Nachricht in Kanal“)
- Filter konfigurieren (z.B. nur bestimmte Kanäle oder Schlüsselwörter)
Langdock-Ordner als Trigger seit September 2026
Die Integration Langdock bringt den Trigger File added to folder. Der Workflow startet, sobald eine Datei oder ein Meeting in den gewählten Ordner hochgeladen oder verschoben wird. Was schon im Ordner liegt und spätere Bearbeitungen lösen nichts aus. Den Inhalt holst du mit der Action Read folder file, Owner, Teilnehmer, Notizen und Transkript eines Meetings mit Get meeting. Persönliche Meeting-Notizen gibt Langdock nie heraus.
- Verbindung per API-Key: Statt OAuth hinterlegst du einen persönlichen oder Workspace-API-Key mit dem Scope Workflow Read API. Read folder file braucht zusätzlich Knowledge Folder API (Dateien) bzw. Meetings Read API (Meetings), Get meeting braucht Meetings Read API.
- Wessen Ordner: Ein persönlicher Key sieht die Ordner seines Owners, ein Workspace-Key alle Ordner, die er sehen darf, inklusive der mit dem ganzen Workspace geteilten. Für produktive Workflows ist der Workspace-Key robuster, weil er nicht am Konto einer Person hängt.
- Dedicated Deployments: Dort als Base URL
https://<deployment-url>/api/publiceintragen.
Workflow-Start aus Chat und Agents seit März 2026
Workflows lassen sich direkt aus dem Chat starten. Das ist streng genommen kein eigener Trigger-Typ, sondern ein zweiter Weg, einen bestehenden Trigger auszulösen. Es gibt zwei Varianten:
- Per @-Menü: Tippe
@im Chat-Eingabefeld, wähle einen Workflow aus der Liste und schicke die Nachricht ab. Die KI entscheidet dann anhand deiner Anfrage, ob sie den Workflow tatsächlich auslöst. - Als Agent-Action: Du hängst Workflows an einen Agenten. Im Agent-Editor unter Actions auf Add action, dann in den Tab Workflows wechseln und auswählen. Der Agent ruft sie danach selbstständig auf, wenn sie zur Konversation passen.
Ideal für On-Demand-Automatisierungen: Du bist mitten in einer Konversation, brauchst eine Auswertung oder möchtest einen Prozess anstoßen, ohne die Chat-Oberfläche zu verlassen.
Seit dem 10.09.2026 auch aus der Desktop-App: Langdock gibt es als eigene Anwendung für macOS und Windows, mit eigenem Icon im Dock oder in der Taskleiste. Nach dem Login mit dem Langdock-Konto siehst du dieselben Chats, Agents und Workflows wie im Browser, eine zusätzliche Einrichtung braucht es nicht. Praktisch beim Bauen: Die App öffnet mehrere Tabs, du kannst also parallel an mehreren Aufgaben arbeiten, und häufige Aktionen laufen über Tastaturkürzel. Ein eigener Trigger-Typ ist das nicht und eine zweite Rechte-Ebene auch nicht, sondern dieselbe Oberfläche in einem eigenen Fenster.
Voraussetzungen: Wann taucht ein Workflow im @-Menü auf?
Alle vier Bedingungen müssen erfüllt sein:
- Der Workflow gehört zu deinem Workspace
- Du hast Zugriff darauf (als Owner oder per Freigabe)
- Der Status ist active, der Workflow ist also veröffentlicht
- Der Trigger-Typ wird im Chat unterstützt
| Trigger-Typ | Im Chat? | Verhalten |
|---|---|---|
| Manual | Ja | Bestätigen und starten, keine Eingabefelder |
| Form | Ja | Formularfelder werden inline im Chat gerendert |
| Scheduled | Ja | Zusätzlich zum Zeitplan on demand auslösbar |
| Webhook | Nein | Nur über die Webhook-URL |
| Integration | Nein | Nur über das App-Event |
Bestätigung ist Pflicht
Kein aus dem Chat gestarteter Workflow läuft ohne ausdrückliche Freigabe. Bei Manual- und Scheduled-Workflows erscheint ein kompaktes Bestätigungspanel mit den Buttons Trigger und Deny. Bei Form-Workflows wird stattdessen das Formular direkt im Chat gerendert und du füllst es aus, bevor du es abschickst.
Felder vom Typ FILE werden dabei mit Dateien aus der laufenden Konversation vorbelegt. Berücksichtigt werden die 50 neuesten Anhänge des Chats.
Statusanzeige im Chat
| Status | Anzeige |
|---|---|
| Läuft | Animierte Anzeige mit dem Workflow-Namen |
| Fertig | Ran [Workflow-Name] in Xs samt Ergebnis |
| Fehlgeschlagen | Rotes Panel mit Fehlerdetails |
| Abgelehnt | Gelber Hinweis auf den Abbruch |
Rechte und Grenzen
- Rechteprüfung zu unterschiedlichen Zeitpunkten: Per @-Menü siehst du nur Workflows, auf die du Zugriff hast. Bei Agent-Actions wird der Zugriff erst zur Laufzeit geprüft, du kannst also mitten im Chat auf einen Zugriffsfehler laufen.
- Freigabe-Sonderfall: Form-Workflows, die an einem Agenten hängen und auf Workspace oder Public stehen, benötigen keine individuelle Freigabe mehr.
- Tool-Name: Aus dem Workflow-Namen wird ein Tool-Name abgeleitet, aus »Summarize Report« also
workflow_summarize_report. Er ist auf 63 Zeichen begrenzt, sehr lange Workflow-Namen werden gekürzt. - Mobile App: Dort lassen sich Workflows nicht per @ erwähnen, offene Bestätigungen können unaufgelöst bleiben.
- Sub-Agenten: Ein Agent, der von einem anderen Agenten aufgerufen wird, kann keine Workflows auslösen.
- Keine Doppelaufrufe: Die KI ruft denselben Workflow innerhalb einer Anfrage nicht zweimal auf.
Node-Typen: Was Workflows können
▼Agent Node – KI-Analyse & Content-Generierung
Der Agent Node ist das Herzstück der meisten Workflows. Hier kommt die KI ins Spiel: Texte analysieren, kategorisieren, zusammenfassen, generieren oder Entscheidungen treffen.
Zwei Optionen:
- Bestehenden Agent verwenden: Nutzt einen Agent aus deinem Workspace mit dessen Konfiguration und Wissen.
- Neuen Agent erstellen: Speziell für diesen Workflow konfiguriert und optimiert.
Structured Output (dringend empfohlen): Definiere das exakte Ausgabeformat als JSON-Schema. Dadurch erhältst du garantiert strukturierte Daten, die nachfolgende Nodes zuverlässig verarbeiten können.
{
  "sentiment": "negativ",
  "category": "bug",
  "priority": "hoch",
  "summary": "App stürzt beim Bild-Upload ab"
}
Max Steps: Standard: 25. Einstellbar je nach Aufgabenkomplexität (5-10 für einfache, 50-100 für komplexe Research-Aufgaben).
Extended Thinking / Reasoning-Toggle (seit Mai 2026): Extended Thinking lässt sich jetzt direkt im Agent Node per On/Off-Schalter aktivieren – eine separate Modellvariante ist nicht mehr nötig. Nur einschalten, wenn die Aufgabe wirklich Schritt-für-Schritt-Logik braucht (Mehrfach-Klassifikation mit Begründung, Routing-Entscheidungen mit mehreren Constraints). Für Standard-Extraktion und einfache Klassifikation lässt du es aus, das spart Token und macht den Run schneller.
Auto Model Mode seit Mai 2026: Im Modell-Selector des Agent Nodes gibt es jetzt einen Auto-Modus, der pro Aufruf das passende Modell anhand der Aufgaben-Komplexität wählt – einfache Klassifikation läuft auf einem kleinen, schnellen Modell, komplexe Analyse auf einem Spitzenmodell. Sinnvoll, wenn du nicht selbst Modell-Routing aufbauen willst. Für vorhersagbare Kosten und reproduzierbare Ergebnisse besser explizit ein Modell wählen.
Verfügbare Tools:
- Web-Suche (für aktuelle Informationen)
- Code-Ausführung (Sandboxed Python)
- Integration Actions (optional mit Human Confirmation)
- Knowledge Folder (Zugriff auf Unternehmenswissen)
- Nested Agent Calls (andere Agents aufrufen)
Prompt Engineering Tipps:
- Sei explizit: „Kategorisiere als Bug, Feature Request oder Frage“ statt nur „Analysiere den Text“
- Gib Kontext: Erkläre die Rolle und den Hintergrund
- Nutze Beispiele: Zeige dem Agent, wie die gewünschte Ausgabe aussehen soll
- Beschränke die Ausgabe: „Antworte NUR mit einer der folgenden Kategorien: ...“
Condition Node – Bedingte Logik
Routet die Workflow-Ausführung basierend auf Bedingungen. Jede Bedingung hat einen eigenen Ausgangs-Pfad.
Typische Anwendungen:
- Priorität prüfen:
{{agent.output.structured.priority === "high"}} - Betrag prüfen:
{{trigger.output.amount > 5000}} - Status prüfen:
{{customer.output.status != "inactive"}}
Verfügbare Operatoren (Manual Mode): Vergleich (===, !==, >, <, >=, <=), Logik (&&, ||, !), String-Methoden (.includes(), .startsWith(), .endsWith()). Mehrere Operatoren lassen sich kombinieren: {{trigger.output.score > 80 && agent.output.verified === true}}.
Modi und Toggles: Im Standard löst die erste zutreffende Bedingung aus, alle weiteren werden übersprungen. Mit Allow multiple conditions laufen alle zutreffenden Pfade parallel. Im Prompt AI-Modus formulierst du die Bedingungen natürlichsprachlich; mit Force Select Branch wird auch bei unklarer Lage immer mindestens ein Branch gewählt.
Code Node – Custom JavaScript
Für Datentransformationen, Berechnungen und benutzerdefinierte Logik, die kein KI braucht.
Perfekt für:
- Mathematische Berechnungen
- Daten umformatieren
- JSON parsen und manipulieren
- Datenvalidierung und -bereinigung
- Datum-/Zeitoperationen
const scores = agent.scores || [];
const average = scores.reduce((a, b) => a + b, 0) / scores.length;

return {
  average_score: average.toFixed(2),
  highest_score: Math.max(...scores),
  grade: average >= 90 ? "A" : average >= 80 ? "B" : "C"
};
Verfügbare Funktionen (JavaScript-Sandbox):
| Bereich | Utilities |
|---|---|
| HTTP & Netzwerk | ld.request(), ld.awsRequest() (signierte AWS-Calls) |
| Datenformate | ld.csv2parquet(), ld.parquet2csv(), ld.arrow2parquet(), ld.json2csv() |
| SQL | ld.validateSqlQuery(), ld.ensureReadOnlySqlQuery() – Query prüfen, bevor sie an eine Datenbank geht |
| Krypto | ld.signWithRS256() – z.B. für Service-Account-JWTs, atob() / btoa() |
| Binärdaten & Formulare | Buffer.from() (schlanker Polyfill: nimmt nur Array, Uint8Array oder ArrayBuffer, keine Strings; für Base64 weiter btoa()), FormData (Multipart-Uploads mit Datei und Metadaten) |
| Debugging & Timing | ld.log(), ld.wait() (Backoff zwischen Retries) |
| Standard-JavaScript | JSON, Date, Math, Array, Object |
ld.request() entfernt beim Redirect auf eine andere Origin standardmäßig den Authorization-Header und andere Credential-Header. Nur wenn du dem Redirect-Ziel wirklich traust, setze preserveAuthOnRedirect: true. Jeder Response-Body ist auf 100 MB begrenzt; größere Antworten scheitern mit Response too large. Für große Dateien: direkt in externen Speicher wie S3 streamen, statt sie durch den Code Node zu schleusen.
Python-Sandbox (alternativ zu JavaScript): Python läuft ohne Internet-Zugriff und ohne ld.*-Utilities, hat dafür vorinstallierte Libraries: pandas, numpy, openpyxl, pypdf. Sinnvoll für tabellarische Auswertungen, Excel-Generierung und PDF-Parsing.
Dateien aus dem Code Node
Beide Sprachen können Dateien erzeugen. In JavaScript gibst du sie in einem files-Array zurück, in Python legst du sie einfach im Working Directory ab. In beiden Fällen landen sie im Output unter _files:
return {
  files: [
    { fileName: "report.csv", mimeType: "text/csv", text: csvContent }
  ]
};

// Zugriff im nächsten Node:
// {{code_node_name.output._files[0]._metadata.name}}
Dateien aus früheren Nodes lesen seit September 2026: Seit dem 18.09.2026 kann der Code Node Dateien lesen, die frühere Nodes mitgebracht oder erzeugt haben, etwa einen Upload aus dem Formular oder einen Webhook-Anhang. Jedes Datei-Objekt trägt einen path, den du in Python direkt an open() übergibst, den ursprünglichen Dateinamen findest du unter _metadata.name. Eine hochgeladene CSV lässt sich so direkt im Code Node parsen, der Umweg über einen Agent Node entfällt.
Limit: 5 MiB Input pro Code Node. Langdock misst vor der Ausführung die Größe aller Upstream-Outputs, die dein Code per Slug referenziert. Wird das Limit überschritten, schlägt der Node mit einem Fehler fehl, bevor dein Code überhaupt läuft. Achtung: Liest du statt einzelner Slugs die data-Map, werden sämtliche Upstream-Outputs geladen und ihre volle kombinierte Größe zählt gegen das Limit.
Typische Ursachen:
- Ein Loop Node, der die Outputs vieler Iterationen in ein einziges Array sammelt
- Ein vorheriger Node mit sehr großer API-Response, Dateiinhalt oder Datensatz
- Tief verschachtelte Objekte, die sich nicht sicher messen lassen
Gegenmaßnahmen: Upstream-Output filtern, zusammenfassen oder nur die benötigten Felder auswählen. Weniger Elemente pro Iteration im vorgelagerten Loop verarbeiten. Oder Collect Outputs im Loop Node deaktivieren.
Und auf der anderen Seite: 25 MB Output pro Node. Das Limit gilt für jeden Workflow-Node, nicht nur für Code Nodes. Gibt dein Code mehr zurück, scheitert der Node mit Node output exceeded the maximum size of 25 MB und das Ergebnis wird gar nicht erst gespeichert. Gute Nachricht: Dateien, die du im files-Array zurückgibst oder in Python ins Working Directory schreibst, werden vorher hochgeladen und zählen nicht gegen dieses Limit. Bei JavaScript kommt eine zweite Grenze dazu: Die komplette Antwort des Code-Execution-Service ist auf 150 MB gedeckelt, inline zurückgegebene Dateien eingerechnet.
HTTP Request Node – Externe APIs
Rufe beliebige externe APIs auf: Daten abrufen, erstellen, aktualisieren oder löschen.
Methoden: GET, POST, PUT, PATCH, DELETE
Profi-Feature: Import from cURL – Paste einen cURL-Befehl aus einer API-Dokumentation, und alle Felder (URL, Headers, Parameter) werden automatisch ausgefüllt.
Konfiguration:
- URL: Unterstützt Variablen, z.B.
https://api.example.com/users/{{trigger.output.user_id}} - Headers: Key-Value-Paare für Auth, Content-Type etc.
- Query Parameters: Sauberer als in der URL hardcodiert
- Body: JSON mit Variablen (bei POST/PUT/PATCH)
Response nutzen:
{{http_node.output.status}}          → Statuscode (200, 404, etc.)
{{http_node.output.data}}             → Response Body
{{http_node.output.data.user.name}}   → Verschachteltes Feld
File Search Node – Unternehmenswissen durchsuchen
Durchsucht deine Knowledge Folder (Wissensordner) und gibt die relevantesten Ergebnisse zurück. Ideal für RAG-Patterns (Retrieval Augmented Generation).
Konfiguration:
- Knowledge Folder auswählen
- Suchanfrage definieren (Manual, Auto oder AI Prompt)
- Max. Ergebnisse festlegen (Standard: 10)
Was ein Knowledge Folder aufnimmt: Durchsuchbar sind textbasierte Formate, also PDFs, Word-Dokumente, Markdown und Präsentationen. Tabellen (Excel, CSV), Bilder, Audio und Video nimmt ein Knowledge Folder nicht an. Solche Daten holst du im Workflow über eine Action aus dem Quellsystem oder wertest sie im Code Node aus. Das ist die häufigste Erklärung dafür, dass eine Datei zwar im Ordner liegt, aber nie als Treffer auftaucht.
Empfehlungen für Max. Ergebnisse:
- 1-3: Fokussierte, spezifische Anfragen
- 5-10: Wenn breiterer Kontext nötig ist
- 10+: Umfassende Suchen (kann Performance beeinflussen)
{{file_search.output.results}}                  → Alle Ergebnisse
{{file_search.output.results[0].text}}          → Text des relevantesten Chunks
{{file_search.output.results[0].similarity}}    → Relevanz-Score (0–1)
{{file_search.output.results[0].fileName}}      → Dateiname
{{file_search.output.results[0].fileUrl}}       → URL zur Quelldatei
{{file_search.output.results[0].mimeType}}      → Dateiformat (z.B. application/pdf)
{{file_search.output.results[0].fileId}}        → Interne File-ID
{{file_search.output.results[0].externalId}}    → ID im verbundenen Quellsystem
{{file_search.output.results[0].connectionId}}  → ID der Integration-Verbindung
{{file_search.output.results[0].fileSize}}      → Dateigröße in Bytes
{{file_search.output.results[0].pageCount}}     → Anzahl Seiten
Erweiterte Metadaten (seit Mai 2026): File-Search-Nodes und Folder-Tools liefern jetzt zusätzlich fileId, externalId, connectionId, fileSize und pageCount, dazu subsource, subname und syncParams als Referenzen auf die Quell-Integration. Damit lassen sich Treffer sauber deduplizieren, gegen das Quellsystem zurückverlinken und nach Größe/Seitenzahl filtern, bevor sie an einen Agent gehen.
Web Search Node – Internet durchsuchen
Durchsucht das Internet und liefert aktuelle Informationen. Perfekt für Fact-Checking, Marktforschung oder sich schnell ändernde Daten.
Modi:
- Automatisch: KI generiert die optimale Suchanfrage
- Manual: Du gibst die exakten Suchbegriffe vor
- Prompt: Anweisungen, aus denen die KI eine Anfrage generiert
Action Node – In verbundene Apps handeln
Führt Aktionen in verbundenen Integrationen aus: Slack-Nachrichten senden, Google Sheets aktualisieren, Jira-Tickets erstellen, E-Mails versenden.
Beispiele nach Integration:
- Slack: Nachricht senden, DM senden, Channel erstellen
- Google Sheets: Zeile hinzufügen, Zeile aktualisieren, Zelle ändern
- Gmail: E-Mail senden, Entwurf erstellen, Label hinzufügen
- Notion: Seite erstellen, Datenbank-Eintrag aktualisieren
- CRM: Kontakt/Deal erstellen, Aktivität loggen
Neu im Integrations-Katalog September 2026
Langdock hat den Katalog um drei Systeme erweitert, die vor allem in Operations und IT relevant sind. Alle drei stehen im Action Node genauso zur Verfügung wie im Chat:
- ServiceNow: IT-Service-Management per OAuth. Incidents anlegen, aktualisieren und abrufen, Kommentare und Work Notes ergänzen, Tasks und Service-Catalog-Einträge durchsuchen sowie Configuration Items in der CMDB abfragen. Voraussetzung ist eine OAuth-Anwendung auf der eigenen ServiceNow-Instanz; die Instanz-URL geben die Nutzer beim Verbinden an, sofern Admins keinen Standard hinterlegen.
- UiPath (Orchestrator): Jobs starten, Queue-Items einstellen, Folder und Prozesse auflisten, Jobs und Audit-Logs auswerten. Unterstützt wird ausschließlich UiPath Automation Cloud, nicht Automation Suite oder andere self-hosted Varianten. Weil UiPath OAuth-Anwendungen je Organisation registriert, gibt es hier keinen zentralen Langdock-Client: Ein UiPath-Admin legt die vertrauliche Anwendung an, ein Workspace-Admin trägt Application ID und Secret als eigenen OAuth-Client ein.
- UiPath Automation Hub: Zweite, getrennte Integration mit eigener Authentifizierung per Open-API-Token. Damit durchsuchst du Automatisierungs-Ideen, Kategorien und Anwendungen und liest den Pipeline-Kontext aus. Praktisch, wenn ein Workflow den Automatisierungs-Backlog anreichern statt Roboter starten soll.
- Shopify Admin: Läuft immer über eine eigene Shopify-App und damit über Bring Your Own OAuth Client. Der Client Secret gehört in die Workspace-Admin-Einstellungen, nie in einen Chat.
Eigene Integration per Chat: Integration Builder Agent Oktober 2026
Fehlt ein Tool im Katalog, musst du die Integration nicht mehr Feld für Feld selbst konfigurieren. Der Integration Builder Agent baut sie aus einer Unterhaltung: Du beschreibst das Tool und was du brauchst, hängst bei Bedarf die API-Doku an, und der Agent recherchiert die API, richtet die Authentifizierung ein (OAuth, API Key oder None) und legt passende Actions und Triggers an. Am Ende bekommst du eine Zusammenfassung mit Auth-Typ und Scopes. Starten lässt er sich über die Vorlage im Chat, über Integrations → Add integration → Start building oder als duplizierte Vorlage unter Agents → Browse templates.
Voraussetzung: Der Agent arbeitet über die Langdock-Integration selbst. Die braucht eine Connection mit einem API Key, der den Scope Integrations API hat, entweder als Workspace-Key vom Admin oder als persönlicher Key, sofern der Admin den Scope dafür freigibt. Ist die neue Integration verbunden, stehen ihre Actions in Chat, Agents und im Action Node deiner Workflows bereit. Auf Dedicated Deployments fehlt das Banner, dort führt der Weg über die Agent-Vorlage.
Connections: Zugänge zu Integrationen
Jeder Action Node und jeder Integration Trigger braucht eine Connection, also eine gespeicherte Authentifizierung zwischen Langdock und dem externen Tool. Vier Typen gibt es:
| Typ | Wofür | Teilbar? |
|---|---|---|
| OAuth | Google Workspace, Microsoft 365, Slack, HubSpot | Nein |
| API Key | OpenAI, Stripe, eigene Integrationen | Ja |
| Service Account | Von Admins hinterlegte Enterprise-Zugänge | Ja |
| None | Öffentliche APIs ohne Authentifizierung | Ja |
Connections sind grundsätzlich nutzergebunden. Jeder sieht nur die Zugänge, die er selbst angelegt hat, und eine OAuth-Connection läuft immer mit den Rechten der authentifizierten Person. OAuth-Zugänge lassen sich deshalb nicht direkt weitergeben: Würde man das Token teilen, könnten Dritte im Namen des ursprünglichen Nutzers handeln. Die drei anderen Typen können Workspace-Admins gezielt freigeben, an einzelne Nutzer, an Gruppen, an Workspace-API-Keys oder an den ganzen Workspace.
Damit trotzdem ein ganzes Team dieselbe Action nutzen kann, gibt es die vorausgewählte Connection (preselected connection) am Agenten: Alle, die den Agenten ausführen, laufen über diesen einen Zugang, ohne die Zugangsdaten je zu sehen. Ohne Vorauswahl nutzt jeder seine eigenen Credentials.
Hast du mehrere Zugänge zur selben Integration, etwa zwei Slack-Workspaces, kannst du einen als Standard markieren. Langdock löst in dieser Reihenfolge auf:
- Vorausgewählte Connection an der Action
- Standard-Connection des Nutzers
- Abfrage, welcher Zugang genutzt werden soll
Action-Level Scopes: welche Actions dein Workspace anbietet
Nicht jede Action einer Integration steht automatisch zur Verfügung. Jede Action braucht bestimmte OAuth-Scopes beim Anbieter, etwa Calendars.ReadWrite für das Ändern von Outlook-Terminen. Workspace-Admins steuern unter Scopes and Action Access in den Integrations-Einstellungen, welche Actions aktiv sind und welche Scopes Langdock beim Verbinden anfragt. Umschalten lässt sich dort zwischen Scope view und Action view.
- New actions enabled by default: Steht der Schalter an, aktiviert Langdock neu hinzugekommene Actions automatisch, sofern die nötigen Scopes schon abgedeckt sind. Steht er aus, bleiben neue Actions inaktiv, bis jemand sie geprüft und freigegeben hat.
- Langdock Client (Default) und Custom OAuth Client mit Scope Sync: Die angefragten Scopes bleiben automatisch mit den aktivierten und geteilten Actions synchron. Aktivierst du eine Action, kommen die nötigen Scopes nach einer Bestätigung dazu; deaktivierst du sie, verschwinden sie wieder, sofern keine andere Action sie braucht.
- Custom OAuth Client mit Fixed Scopes: Hier pflegen Admins die Scope-Liste selbst. Actions ohne passenden Scope tragen ein Missing scope-Badge. Aktivieren lässt sich so eine Action zwar, ausführen aber nicht, solange der Scope in der OAuth-App fehlt.
- Native Actions (Datei-Anhänge, Ordner-Sync, Knowledge-Zugriff, ID-Auflösung) sind immer aktiv. Ihre Scopes lassen sich in den Sync-Modi nicht entfernen.
- Export scope configuration: Liefert eine CSV mit Name, Beschreibung, benötigten Scopes, Aktiv-Status und Freigaben je Action. Praktisch, wenn die IT vor dem Go-Live eines Workflows wissen will, welche Rechte tatsächlich angefragt werden.
Fehlt dir im Action Node eine Action, die es laut Dokumentation geben müsste, liegt das also meist nicht am Workflow, sondern an dieser Freigabe. Und nach jeder Scope-Änderung müssen die Nutzer ihre Connection einmal erneuern, sonst greifen die neuen Rechte nicht. Seit Mitte September 2026 liegen diese Freigaben unter dem Sammelbegriff Plugins: Langdock führt Integrationen, Skills und Tools dort an einer Stelle zusammen. An der Logik der Action-Level Scopes ändert das nichts, nur am Weg dorthin.
Microsoft-Scopes nachschlagen seit September 2026
Für die Microsoft-Integrationen dokumentiert Langdock seit September 2026 die minimal nötigen delegierten Scopes Action für Action, aufgeteilt nach Dienst: Outlook Calendar, Outlook Email, OneDrive, SharePoint, Teams, Planner, To Do, Entra, Power BI, Dynamics 365 und Excel. Dort steht schwarz auf weiß, welcher Microsoft-Graph-Scope hinter einer Action steckt, etwa Files.Read.All für Get file in SharePoint, Sites.ReadWrite.All für Create list item oder Mail.Send für den Versand aus dem eigenen Postfach. Jede Connection fragt zusätzlich die Basis-Scopes openid, email, offline_access und User.Read an. Plane das ein, bevor du der IT eine Liste schickst: Ein Workflow, der eine Outlook-Mail beantwortet, braucht Mail.ReadWrite und Mail.Send zusammen, und für ein gemeinsames Postfach jeweils die .Shared-Variante.
Image Generation Node – Bilder erzeugen
Erzeugt Bilder aus Text-Prompts direkt im Workflow. Ideal für Marketing-Assets, Social Media Content oder dynamische Visualisierungen.
Konfiguration:
- Prompt: Text-Beschreibung des gewünschten Bildes (Manual, Auto oder AI Prompt Mode). Unterstützt Variablen, z.B.
Ein {{trigger.output.style}} Bild von {{agent.output.structured.subject}} - Bildmodell: Zwei Modelle beteiligt – ein LLM optimiert den Prompt, ein Bildmodell generiert das Bild. In Manual Mode wird nur das Bildmodell genutzt. Verfügbar sind u.a. GPT Image 2 (seit April 2026, bis 2K-Auflösung) und Stable Diffusion – die genaue Modell-Liste hängt von der Workspace-Konfiguration ab.
- Seitenverhältnis: Square (1:1, Social Media/Profilbilder), Landscape (16:9, Präsentationen/Banner), Portrait (9:16, Stories/Mobile)
- Stil-Presets: Auto, Photorealistisch, Digital Art, Ölgemälde, Aquarell, Sketch, Anime, 3D Render, Minimalistisch, Cinematic
Output:
| Feld | Beschreibung |
|---|---|
{{image_gen.output.imageUrl}} | URL zum generierten Bild (7 Tage gültig) |
{{image_gen.output.imagePath}} | Dateipfad |
{{image_gen.output.attachmentId}} | Attachment-ID für Weiterverarbeitung |
{{image_gen.output.prompt}} | Der tatsächlich verwendete Prompt |
{{image_gen.output.aspectRatio}} | Gewähltes Seitenverhältnis |
Limits: Timeout 60 Sekunden, nur PNG-Format, keine Bild-zu-Bild-Funktion, URL-Gültigkeit 7 Tage.
Weiterverarbeitung: Agent Node (Bildanalyse), Action Node (in Slack/E-Mail teilen), HTTP Request (Upload auf externen Server), Loop Node (Batch-Generierung mehrerer Bilder).
Loop Node – Über Listen iterieren
Verarbeitet Arrays von Daten: Gehe eine Liste von Kunden, Bestellungen oder Dateien durch und wende auf jedes Element dieselbe Logik an.
Konfiguration:
- Input Array: Das Array, über das iteriert wird (z.B.
{{trigger.output.customers}}) - Max Iterations: Sicherheitslimit (Standard: 200, Maximum: 2.000)
- Concurrency: Off (sequenziell, Standard) oder On (parallel – schneller bei unabhängigen Iterationen, Reihenfolge dann nicht garantiert)
- Collect Outputs: Aggregiert alle Iterationen in ein Output-Objekt mit
iterations(Array aus Index, Item-Daten und Ausführungsdetails) undtotal(Anzahl). Nachfolgende Nodes greifen so gebündelt auf alle Ergebnisse zu.
{{loop_node.output.currentItem}}        → das aktuelle Datenobjekt
{{loop_node.output.currentItem.name}}   → verschachtelter Zugriff
{{loop_node.output.currentIndex}}       → aktuelle Position (0-basiert)
{{loop_node.output.total}} → GesamtanzahlLoops mit Agent-Nodes können teuer werden. 100 Elemente × 0,10 € pro Agent-Call = 10 € pro Workflow-Run. Berechne vorher die Kosten und setze ein realistisches Max-Iterations-Limit.
Delay Node – Pause einlegen
Pausiert die Workflow-Ausführung für eine definierte Dauer (1 Sekunde bis 24 Stunden).
Typische Anwendungen:
- API-Polling (regelmäßig prüfen, ob ein Prozess fertig ist)
- Rate-Limiting (API-Throttling vermeiden)
- Retry-Logik mit Backoff
User Input Node: auf einen Menschen warten seit September 2026
Pausiert den Lauf, bis eine Person entscheidet oder fehlende Angaben nachreicht, und führt ihn dann auf dem passenden Zweig weiter. Den Ablauf mit Benachrichtigungen und Monitor beschreibt Kapitel 8.
- Type Approval: Du schreibst eine Message und verbindest die Ausgänge Approve und Reject.
- Type Form: Du schreibst eine Description, legst Felder an und verbindest Continue. Einen Reject-Ausgang gibt es hier nicht.
- Fehlerverhalten: Bei Approval ist Continue (using error output) nicht wählbar, nur Stop workflow oder Add error callback.
Transcribe Audio Node: Audio in Text umwandeln seit September 2026
Seit dem 18.09.2026 wandelt dieser Node Audio direkt im Workflow in Text um. Typische Quellen sind ein Datei-Upload im Formular, ein E-Mail-Anhang, eine Datei aus Drive oder ein Webhook. Den Text gibst du danach an einen Agent Node, der daraus ein Protokoll, eine Zusammenfassung oder eine Klassifikation macht. Unterstützte Formate, maximale Länge und das verwendete Modell nennt die öffentliche Doku noch nicht: Teste vor dem produktiven Einsatz mit einer realistischen Aufnahme.
Send Notification Node – Benachrichtigungen
Sendet Alerts direkt in dein Langdock-Postfach. Unterstützt Markdown-Formatierung und Variablen.
Empfänger: Bei manuell/formular-ausgelösten Workflows der auslösende Benutzer, bei zeitgesteuerten/webhook/integration Workflows der Workflow-Ersteller. Für externe Empfänger den Action Node mit Slack, Gmail etc. verwenden.
Eingabemodi: Manual (direkte Nachricht), Auto (KI generiert basierend auf Kontext) oder Prompt AI (eigene KI-Anweisungen).
Gute Benachrichtigungen enthalten:
- Klare Überschrift mit Priorität
- Relevante Daten (Name, ID, Kategorie)
- Konkreten nächsten Schritt („Bitte innerhalb von 1 Stunde reagieren“)
Output Node – Ergebnisse speichern & anzeigen
Der Output Node ist der Endpunkt eines Workflows. Er speichert einen aufgelösten Wert als Ergebnis des Workflow-Runs – sichtbar in der Run-History, über die API und direkt im Chat.
Besonders wichtig bei Chat-Integration: Wenn ein Workflow aus dem Chat gestartet wird, erscheint der Output als formatiertes Ergebnispanel direkt in der Konversation – mit Workflow-Name, Ausführungszeit und Inhalt.
Konfiguration:
- Value Field: Template-Ausdruck mit Variablen aus vorherigen Nodes (nur Manual Mode)
- Slug: Automatisch generierter camelCase-Identifier – muss bei mehreren Output Nodes eindeutig sein
- Mehrere Outputs: Ein Workflow kann mehrere Output Nodes enthalten, die jeweils separate Schlüssel im Ergebnis-Objekt liefern
// Einzelner Output
{{output_node.output.value}}

// Beispiel: Zusammenfassung als Output
Value: "{{agent.output.structured.summary}}"

// Beispiel: Kombinierte Daten
Value: "Report für {{trigger.output.customer_name}}: {{agent.output.structured.analysis}}"Variablen & Datenfluss
▼Das Grundprinzip
Variablen sind das Nervensystem deines Workflows. Wenn ein Node fertig ist, wird sein Output als Variable verfügbar – und alle nachfolgenden Nodes können darauf zugreifen.
Syntax
{{node_name.output.field_name}}Aufschlüsselung:
node_name= Der eindeutige Name deines Nodes (z.B.form1,analyze_data)output= Das Standard-Output-Objekt jedes Nodesfield_name= Das spezifische Datenfeld
Verschachtelte Daten
Reale Daten sind selten flach. Nutze Dot-Notation für verschachtelte Zugriffe:
{{node.output.user.profile.email}}           → Verschachteltes Objekt
{{api_response.output.data.items[0].title}}  → Array-Element
{{trigger.output.tags}}                       → Gesamtes Array
{{agent.output.structured.summary}}           → Structured Output
Autocomplete nutzen
Variablen mehrfach verwenden
Ein Output kann in beliebig vielen nachfolgenden Nodes verwendet werden:
Trigger (form1) →
  ├─ Agent (analysiere {{form1.output.message}})
  ├─ HTTP Request (logge {{form1.output.email}})
  └─ Notification (benachrichtige über {{form1.output.priority}})
Variablen kombinieren
Mische Daten aus verschiedenen Nodes in einem Feld:
Neue Bestellung #{{trigger.output.order_id}} von {{customer.output.name}} über {{trigger.output.amount}} €Nodes umbenennen
Wenn du einen Node umbenennst, werden alle Variablen-Referenzen automatisch aktualisiert – kein manuelles Nacharbeiten nötig. Gib Nodes deshalb von Anfang an sprechende Namen:
- ✔
FeedbackAnalysieren,PrioritätPrüfen,SlackBenachrichtigen - ✘
agent1,condition2,action3
Umgebungsvariablen: Konfiguration einmal pflegen seit September 2026
Seit dem 18.09.2026 lassen sich Werte, die mehrere Workflows brauchen, einmal als Environment Variable definieren und überall wiederverwenden: Basis-URLs, IDs von Channels oder Ordnern, Schwellenwerte. Konfiguration bleibt so über alle Workflows hinweg gleich und steht nirgends hart kodiert in einem Node.
- Wann sinnvoll: Sobald derselbe Wert in mehr als einem Workflow auftaucht. Wechselt dann der Channel oder die Schwelle, änderst du ihn an einer Stelle.
- Noch offen: Syntax, Geltungsbereich und den Umgang mit Secrets beschreibt die öffentliche Doku noch nicht. Prüf beim ersten Einsatz im Builder, wie die Variable ins Feld eingefügt wird, und leg Zugangsdaten erst dort ab, wenn klar ist, wer sie sehen kann.
Field Modes: Auto, Manual & AI Prompt
▼Jedes Konfigurationsfeld in einem Node kann in einem von drei Modi betrieben werden. Die richtige Wahl hat direkten Einfluss auf Qualität, Kosten und Kontrolle.
Auto Mode
Die KI bestimmt automatisch den passenden Wert basierend auf dem Kontext vorheriger Nodes.
| Vorteile | Schnelles Setup, sehr flexibel, deckt Edge Cases ab |
| Nachteile | Verbraucht AI Credits, weniger Kontrolle, kann bei häufiger Ausführung teuer werden |
| Ideal für | Einfaches Daten-Mapping, wenn der Kontext offensichtlich ist |
Manual Mode
Du gibst exakte Werte ein oder referenzierst Variablen – keine KI-Verarbeitung.
| Vorteile | Volle Kontrolle, keine AI Credits, schnellste Ausführung, vorhersagbar |
| Nachteile | Manueller Aufwand, kein dynamischer Content |
| Ideal für | Feste Werte (API-Keys, E-Mail-Adressen), exakte Variablen-Referenzen, Templates |
Feld: "E-Mail-Betreff"
Mode: Manual
Wert: "Neue Bestellung #{{trigger.output.order_id}} von {{trigger.output.customer_name}}"
Ergebnis: "Neue Bestellung #12345 von Max Müller"
AI Prompt Mode
Natürlichsprachliche Anweisungen, aus denen die KI dynamischen Content generiert.
| Vorteile | Intelligenter, kontextbezogener Content, spart Template-Arbeit |
| Nachteile | Verbraucht AI Credits, langsamer, Output kann variieren |
| Ideal für | E-Mail-Texte, Zusammenfassungen, dynamische Nachrichten |
Feld: "E-Mail-Text"
Mode: AI Prompt
Anweisung: "Schreibe eine freundliche 2-Absatz-Antwort auf {{trigger.message}},
die auf das Problem {{agent.issue_category}} eingeht und eine Lösung anbietet."
Entscheidungsbaum: Welcher Mode?
Ist der Wert immer gleich?
└─ Ja → Manual Mode (statischer Text)

Kommt der Wert unverändert aus einem vorherigen Node?
└─ Ja → Manual Mode (mit Variablen)

Muss KI den Content generieren oder transformieren?
├─ Ja → AI Prompt Mode
└─ Nein → Auto Mode (nur wenn einfaches Mapping)Guardrails & Sicherheit
▼Der Guardrails Node validiert Inhalte mit KI-gestützten Prüfungen – bevor sie an Kunden gehen, gespeichert oder veröffentlicht werden.
Verfügbare Guardrails
PII-Erkennung (Personenbezogene Daten)
Erkennt Namen, E-Mail-Adressen, Telefonnummern, Adressen, Kreditkartennummern etc.
- Empfohlener Schwellenwert: 0,7–0,8
- Einsatz: DSGVO-Compliance, bevor Daten extern geteilt werden
Moderation
Prüft auf unangemessene, schädliche oder beleidigende Inhalte.
- Empfohlener Schwellenwert: 0,6
- Einsatz: Nutzer-generierte Inhalte, öffentliche Kommunikation
Jailbreak-Erkennung
Erkennt Versuche, KI-Sicherheitskontrollen zu umgehen.
- Empfohlener Schwellenwert: 0,7
- Einsatz: Öffentlich zugängliche KI-Interfaces, User-Prompts validieren
Halluzinations-Erkennung
Erkennt, wenn KI-generierte Inhalte falsche oder nicht verifizierbare Informationen enthalten.
- Empfohlener Schwellenwert: 0,6–0,7
- Einsatz: Faktenbasierte Content-Generierung, Kundenkommunikation
Custom Evaluation
Definiere eigene Validierungskriterien in natürlicher Sprache.
- Einsatz: Brand Voice prüfen, domänenspezifische Regeln, eigene Qualitätsstandards
Kriterien: "Prüfe, ob die Antwort unserer Brand Voice entspricht:
- Professioneller aber freundlicher Ton
- Keine Fachbegriffe oder Abkürzungen
- Kunde wird beim Namen angesprochen
- Klare nächste Schritte werden genannt"
Schwellenwerte richtig setzen
| Schwellenwert | Verhalten | Einsatz |
|---|---|---|
| 0,3–0,5 | Nachsichtig | Vermeidung von False Positives |
| 0,6–0,7 | Ausgewogen | Die meisten Anwendungsfälle |
| 0,8–0,9 | Streng | Hochrisiko-Szenarien |
| 0,9–1,0 | Sehr streng | Nur offensichtliche Verstöße |
Mehrere Guardrails kombinieren
In der Praxis werden häufig mehrere Guardrails in einem Node aktiviert. Eine typische Kombination: PII-Erkennung + Moderation + Custom Evaluation für Brand Voice.
Human in the Loop: Wann der Mensch entscheidet
▼Für sensible Schritte kannst du den Lauf anhalten, bis ein Mensch entschieden hat. Dafür gibt es zwei Werkzeuge: den User Input Node seit September 2026 für Freigaben und Rückfragen mitten im Ablauf, und den Schalter Human in the loop am Action Node, der eine einzelne Aktion erst nach Bestätigung durch jemanden mit Editor-Zugriff ausführt.
Ablauf
- Der Workflow erreicht den User Input Node und pausiert
- Die Personen unter Settings → Notifications → Recipients bekommen eine Inbox-Benachrichtigung. Testläufe verschicken keine
- Jemand mit Editor-Zugriff antwortet, direkt aus der Benachrichtigung oder im Monitor unter Action required → Review
- Der Workflow läuft auf dem passenden Zweig weiter (Approve, Reject oder bei Type Form Continue)
Achtung, zwei verschiedene Kreise: Antworten darf jede Person mit Editor-Zugriff, benachrichtigt werden aber nur die eingetragenen Recipients, nicht alle Editoren. Wer eine Freigabe erwartet, muss also in der Empfängerliste stehen. Und weil Testläufe keine Benachrichtigung auslösen, prüfst du den Freigabeweg am besten mit einem veröffentlichten Lauf.
Wann sinnvoll?
- ✔ Finanzielle Transaktionen über einem Schwellenwert
- ✔ Irreversible Aktionen (Datenlöschung, Vertragsversand)
- ✔ Kundenkommunikation, die Qualitätsprüfung braucht
- ✔ Produktionsänderungen mit Risikopotenzial
- ✔ Fehlende Angaben mitten im Lauf nachfragen (User Input, Type Form)
Wann NICHT sinnvoll?
- ✘ Routine-Aktionen mit niedrigem Risiko
- ✘ Schritte, die sofort ausgeführt werden müssen
- ✘ Hochfrequente Aktionen (werden sonst zum Bottleneck)
Monitor: offene Freigaben an einer Stelle
Genehmigungen musst du nicht im einzelnen Workflow suchen. Unter Workflows → Monitor sammelt Langdock alle Läufe, die auf jemanden warten: Der Bereich Action required listet die pausierten Runs, über Review siehst du die Details und entscheidest mit Approve oder Reject.
Für Teams ist das der eigentliche Hebel: Solange Freigaben nur als Benachrichtigung existieren, hängen sie an der Aufmerksamkeit einzelner Personen. Der Monitor macht daraus eine gemeinsame Liste, die jeder Editor abarbeiten kann.
Smart Approval mit Conditions
Kombiniere Conditions mit Human in the Loop, um Genehmigung nur bei Bedarf einzufordern:
Agent: Rechnungsbetrag berechnen

Condition: Betrag > 5.000 €?
├─ Ja → User Input (Approval): Zahlung prüfen → Zahlung ausführen
└─ Nein → Zahlung direkt ausführen
So hast du Automatisierung für Routine-Fälle und Kontrolle für Ausnahmen.
Versionierung & Deployment
▼Draft Version (v0)
Deine Sandbox zum Experimentieren. Änderungen hier haben keinen Einfluss auf die Produktion. Teste ausgiebig, bevor du veröffentlichst.
Auto-Save & Change Summaries seit April 2026: Drafts werden automatisch gespeichert – kein „Speichern“-Klick mehr nötig. Beim Veröffentlichen schlägt Langdock eine Change Summary vor (welche Nodes/Felder sich seit der letzten Version geändert haben). Die Summary landet im Versionsverlauf und macht Rollback-Entscheidungen später leichter nachvollziehbar.
Node-Umbenennungen zählen jetzt als Änderung seit Juni 2026: Wenn du einen Node umbenennst, erkennt Langdock das als Change und nimmt es in die Change Summary auf. Vorher blieben reine Umbenennungen unbemerkt, sodass eine veröffentlichte Version trotz abweichender Node-Namen als unverändert galt. Jetzt ist der Versionsverlauf auch bei kosmetischen Umbenennungen vollständig.
Veröffentlichte Versionen
Wenn du zufrieden bist, erstellst du eine neue Version (v1.0.0, v1.1.0 etc.). Veröffentlichte Versionen sind:
- Unveränderlich: Können nicht mehr bearbeitet werden
- Aktiv für Trigger: Nur aktive Versionen reagieren auf echte Events
- Dokumentiert: Jede Version hat eine Beschreibung der Änderungen
- Rollback-fähig: Du kannst jederzeit eine ältere Version reaktivieren
Versionsnummern (Semantic Versioning)
| Bump-Typ | Beispiel | Wann? |
|---|---|---|
| Patch | 1.0.0 → 1.0.1 | Bugfixes, kleine Anpassungen |
| Minor | 1.0.0 → 1.1.0 | Neue Features oder Nodes |
| Major | 1.0.0 → 2.0.0 | Breaking Changes |
Workflow-Status
| Status | Bedeutung |
|---|---|
| Not deployed | Wird gebaut – keine Trigger aktiv |
| On | Veröffentlicht und reagiert auf Trigger |
| Off | Existiert, aber temporär deaktiviert |
Workflows API: Workflows aus eigenen Systemen verwalten seit September 2026
Die öffentliche Workflows API legt den ganzen Lebenszyklus offen: Workflows auflisten, abrufen, anlegen, ändern, veröffentlichen und löschen, dazu die Läufe seitenweise lesen. Damit lässt sich etwa ein Workflow aus einem Repository synchronisieren oder ein Draft automatisiert veröffentlichen.
| Scope | Erlaubt |
|---|---|
WORKFLOW_API (Workflow Read API) | Auflisten, einzeln abrufen, paginierte Läufe (/workflows/v1/runs) und der flache Run-Export |
WORKFLOW_WRITE_API | Anlegen, ändern, veröffentlichen. Auf persönlichen Keys nur, wenn der Admin es erlaubt |
WORKFLOW_DELETE_API | Löschen. Nur auf Workspace-Keys, nie auf persönlichen |
- Draft und Live getrennt:
nodesundedgesbeschreiben den Draft (v0),activeVersiondie veröffentlichte Fassung. Secrets kommen geschwärzt zurück und bleiben erhalten, wenn du den geschwärzten Wert unverändert zurückschickst. - Limits per API: Das Objekt
limitsträgtmonthlyCostUsd,perRunCostUsdundmaxExecutionsPerHour. - Wer handelt: Workspace-Keys laufen als Service-Account, persönliche Keys als ihr Owner. Neu angelegte Workflows bleiben privat, bis sie über
shareWithoder von Hand geteilt werden. Paginierte Läufe brauchen Editor-Zugriff.
Kostenmanagement
▼Wo entstehen Kosten?
- Agent Nodes: Verbrauchen AI Credits basierend auf Modell und Token-Menge
- Auto Mode Fields: Nutzen KI im Hintergrund → AI Credits
- AI Prompt Mode Fields: Nutzen KI für Content-Generierung → AI Credits
- Web Search: Kosten pro Suche
- Loops: Multiplizieren die Kosten pro Element
Kosten-Treiber Nr. 1: Loops mit Agent Nodes
Die häufigste Kostenfalle: Ein Loop über 100 Elemente mit einem Agent-Call pro Element.
Rechnung: 100 Elemente × 0,10 € Agent-Cost = 10 € pro Workflow-Run
Bei täglicher Ausführung: 300 € pro Monat – nur für diesen einen Workflow.
Loops mit Agent-Nodes können schnell teuer werden. Berechne immer die erwarteten monatlichen Kosten vor dem Go-Live: Kosten pro Run × erwartete Runs pro Tag × 30.
Strategien zur Kostensenkung:
- Batching: Statt 100 einzelne Agent-Calls → Elemente in Gruppen von 10 zusammenfassen
- Günstigere Modelle: Nicht jede Aufgabe braucht ein Spitzenmodell wie GPT-6 Astra, GPT-5.6 Sol, Claude Opus 5 oder Claude Fable 5.1 (seit dem 01.09.2026 auf Langdock, EU-gehostet und in Workspaces mit Fable 5 automatisch aktiviert). GPT-6 Astra steht seit dem 07.09.2026 auf Langdock bereit und ist OpenAIs bisher stärkstes Modell, laut Langdock ein Schritt über GPT-5.6 Sol bei komplexem Reasoning, Coding, Computer Use, Recherche und Fachaufgaben. Es ist EU-gehostet und wurde in allen Workspaces, in denen bereits eine frühere GPT-Version aktiv war, automatisch freigeschaltet; den Zugriff regeln Admins in den Workspace-Settings. Bestehende Workflows wechseln dadurch nicht von selbst: Ein Agent Node behält das Modell, das in ihm hinterlegt ist. Neu ist nur die Auswahl, und genau dort lohnt der zweite Blick, bevor jemand in einem Loop Node auf das größte Modell umstellt. Für einfache Kategorisierung reicht oft Haiku 4.5, GPT-5.6 Luna oder Gemini 3.8 Flash, das seit dem 02.09.2026 Googles aktuelles Flash-Modell in Langdock ist und Gemini 3.7 Flash ablöst. Auch Gemini 3.8 Flash ist EU-gehostet und in Workspaces mit einer früheren Gemini-Version automatisch aktiviert. Ein Modellwechsel in einem laufenden Workflow gehört trotzdem in die Draft-Version und einmal durch die Testläufe: Günstiger heißt nicht automatisch gleich gut für deinen Prompt. Neu seit Ende September 2026: Claude Opus 5.5, GPT-6 Sol und GPT-6 Luna (23.09.), Claude Sonnet 5.5 (28.09.) und GPT-6.1 Sol (30.09.), alle EU-gehostet und automatisch dort aktiviert, wo das jeweilige Vorgängermodell lief. Für agentische Mehrschritt-Aufgaben ist Sonnet 5.5 der neue Standard, Opus 5.5 bleibt den schwersten Analysen vorbehalten und ist laut Preisliste sogar günstiger als Opus 5. GPT-6 Luna ist für fokussierte Aufgaben in hoher Stückzahl gebaut und damit ein Kandidat für Agent Nodes in Loops, GPT-6 Sol und GPT-6.1 Sol zielen auf komplexe, agentische Abläufe. Auch hier gilt: Bestehende Agent Nodes wechseln nicht von selbst. Neu im Oktober 2026: Claude Haiku 5.5 (08.10.) ist laut Anthropic das bisher günstigste, schnellste und stärkste kleine Claude-Modell, gebaut für Arbeit in hoher Stückzahl wie Zusammenfassungen und Subagent-Aufgaben. Damit ist es der naheliegende Nachfolger von Haiku 4.5 für Kategorisierung und Agent Nodes in Loops. Gemini 4 Argon (13.10.) bringt stärkeres Reasoning und Schreiben für komplexe Fachaufgaben und mehrstufige Abläufe. Beide sind EU-gehostet und automatisch dort aktiviert, wo bereits Anthropic- bzw. Gemini-Modelle liefen. Bestehende Agent Nodes bleiben auch hier beim hinterlegten Modell.
- Manual statt Auto Mode: Feste Werte und einfache Variablen-Referenzen kosten nichts
- Conditions vor Agent Nodes: Filtere irrelevante Daten, bevor sie den teuren Agent erreichen
Kosten monitoren
- Prüfe den Usage-Tab nach jedem Test-Run
- Setze Spending Limits in den Workflow-Einstellungen
- Berechne die erwarteten monatlichen Kosten vor dem Go-Live:
Kosten pro Run × erwartete Runs pro Tag × 30 - CSV-Export der API-Kosten seit April 2026: Admin-Usage lässt sich jetzt als CSV exportieren – ideal für interne Cost-Reports, Verrechnung nach Team/Kostenstelle oder Abgleich mit dem Workspace-Budget.
Limits
| Limit-Typ | Verhalten |
|---|---|
| Monthly Limit (pro Workflow) | Neue Runs werden blockiert, sobald das Monatslimit erreicht ist. Eingebaute Alerts bei 80% und 95% des Workflow-Monatslimits. Fortschrittsbalken zeigt Verbrauch gegen Limit. Default neue Workflows: 25 USD/Monat |
| Execution Limit (pro Run) | Einzelner Run wird gestoppt, wenn er den Betrag überschreitet (verhindert Loop/Retry-Eskalation) |
| Execution Steps | Max. 2.000 Schritte pro Workflow-Ausführung (Workspace-Default). Jede Node-Ausführung zählt als Schritt, auch jede Iteration in einem Loop. Schützt vor Endlos-Loops |
| Max Executions Per Hour | Begrenzt, wie oft der Workflow pro Stunde starten darf, schützt vor Trigger-Storms, besonders bei Webhooks. Standard 100, einstellbar bis maximal 5.000 Läufe pro Stunde |
| Alert Thresholds | Zusätzliche eigene Beträge (z.B. 25 USD, 50 USD), bei denen du per E-Mail benachrichtigt wirst |
Workspace-Admin-Kontrolle (Settings → Products → Workflows):
- Workspace Spend Limit: Organisationsweite Obergrenze für alle Workflow-AI-Kosten. Standard 500 €, Bereich 0 bis 100.000 €. Ist sie erreicht, stoppen alle Ausführungen, die KI-Modelle brauchen – unabhängig von den Einstellungen der einzelnen Workflows
- Abrechnungszeitraum: In Trial-Workspaces zählt die gesamte Trial-Nutzung (Lifetime usage, kein Reset), in allen anderen Plänen der laufende Kalendermonat mit Reset am Monatsersten (Billing month)
- Default Monthly Limit per Workflow: Standard für neue Workflows (1–10.000 USD, Default 25 USD)
- Maximum Monthly Limit per Workflow: Obergrenze, die Workflow-Besitzer nicht überschreiten dürfen (Default: unbegrenzt). Senkst du diesen Wert, werden bestehende Workflow-Limits darüber automatisch nach unten angepasst – Langdock zeigt dir vorher eine Zusammenfassung der betroffenen Workflows. Admin-gesetzte Override-Limits bleiben davon unberührt
- Monthly Run Limit: Maximale Anzahl Workflow-Ausführungen pro Monat, abhängig vom Plan (in der Cloud standardmäßig 2.500). Greift unabhängig vom Budget, auch ein Workflow ganz ohne KI-Kosten zählt mit
- Code Node Toggle: Admins können das Ausführen von Custom JavaScript workspaceweit deaktivieren
- HTTP Node Toggle: Admins können den HTTP Request Node workspaceweit deaktivieren. Achtung: JavaScript-Code-Nodes erreichen externe APIs weiter über
ld.request(). Wer ausgehende Requests wirklich unterbinden will, schaltet beide Nodes ab. Bestehende Workflows scheitern danach an genau diesem Schritt
Admins bekommen In-App- und E-Mail-Benachrichtigungen bei 50%, 90% und 100% des Workspace Spend Cap. Auf dedizierten Deployments gehen die E-Mails nur raus, wenn dort ein E-Mail-Versand konfiguriert ist.
Wer wird benachrichtigt?
Wen ein Workflow informiert, legst du in den Workflow-Settings unter Notifications fest. Die Auswahl gilt gleichermaßen für E-Mail und Inbox.
- Jede hinzugefügte Person startet mit beiden Themen: Failures (fehlgeschlagene Läufe) und Spend alerts (Kostenschwellen).
- Pro Person lässt sich genau eines der beiden Themen abschalten. Mindestens eines muss aktiv bleiben, wer gar nichts bekommen soll, gehört aus der Liste entfernt.
- Die selbst gesetzten Alert Thresholds gehen an alle, bei denen Spend alerts an ist.
- Anti-Spam-Regel: Fehler-E-Mails zu veröffentlichten Läufen gehen höchstens einmal pro Stunde raus. Danach wartet die nächste E-Mail, bis wieder ein veröffentlichter Lauf erfolgreich war.
Kosten je Workflow auswerten: Usage Export API
Neben der Run-Historie gibt es einen Endpoint, der genau eine Zeile pro Workflow liefert und damit für Reporting taugt:
POST https://api.langdock.com/export/workflowsZurück kommt eine Zeile je Workflow, der im gewählten Zeitraum Läufe oder Kosten hatte, Templates ausgenommen. Enthalten sind unter anderem workflow_name, status (ACTIVE, INACTIVE, NOT_DEPLOYED), runs, total_cost_usd, monthly_limit_usd, current_month_cost_usd und monthly_utilization_pct_current, also die Auslastung des Monatslimits.
- Ist die Auswertung auf Nutzerebene im Workspace deaktiviert, fehlen
workflow_owner_idundworkflow_owner_email, und rein private Workflows fallen ganz aus dem Export. - In BYOK-Workspaces kommen Token-Spalten dazu (
sum_input_tokens,sum_cached_input_tokens,sum_cache_creation_tokens,sum_output_tokens), weil dort die Modell-Keys im Haus liegen. group_byunterstützt dieser Export nicht. Requests direkt aus dem Browser blockt Langdock bewusst, der Key gehört serverseitig hinterlegt.
Damit beantwortest du die Frage, die in jedem Review kommt: Welche zehn Workflows verbrauchen das meiste Budget, und wie nah sind sie an ihrem Limit?
10 Workflow-Blueprints für die Praxis
▼Blueprint 1: Kundenfeedback-Verarbeitung
Form Trigger
→ Agent: Sentiment, Kategorie, Priorität analysieren (Structured Output)
→ Condition: Priorität = "hoch"?
  ├─ Ja → Notification: Team benachrichtigen
  │       → Action: Slack-Nachricht an #support
  └─ Nein → (weiter)
→ Action: Zeile in Google Sheets hinzufügen
Kostenabschätzung: ~0,05 € pro Submission (ein Agent-Call)
Blueprint 2: E-Mail-Triage & Auto-Routing
Gmail Trigger (neue E-Mail im Support-Postfach)
→ Agent: Anliegen kategorisieren, Dringlichkeit bewerten (Structured Output)
→ Condition: Kategorie prüfen
  ├─ "Technisches Problem" → Action: Jira-Ticket erstellen
  ├─ "Vertriebsanfrage" → Action: Slack-DM an Sales-Team
  ├─ "Rechnungsfrage" → Action: Weiterleitung an Buchhaltung
  └─ "Sonstiges" → Notification: Manager informieren
→ Action: Label in Gmail setzen
Blueprint 3: Wöchentlicher Automatisierter Report
Scheduled Trigger (Montag 8:00)
→ HTTP Request: Sales-Daten aus CRM abrufen
→ HTTP Request: Support-Tickets aus Jira abrufen
→ Code: KPIs berechnen (Umsatz, Ticket-Volumen, Conversion Rate)
→ Agent: Executive Summary generieren
→ Action: E-Mail an Management-Team mit Report
→ Action: Report in Google Drive ablegen
Blueprint 4: Bewerbungs-Screening
Form Trigger (Bewerbung)
→ Agent: Lebenslauf analysieren, Skills extrahieren (Structured Output)
→ File Search: Stellenbeschreibung im Knowledge Folder suchen
→ Agent: Fit-Score berechnen (0-100) basierend auf Anforderungen vs. Profil
→ Condition: Score prüfen
  ├─ ≥ 80 → Action: Einladung per E-Mail senden
  ├─ 50-79 → Action: In Shortlist-Sheet eintragen + HR benachrichtigen
  └─ < 50 → Action: Freundliche Absage per E-Mail
→ Action: Alle Daten in Recruiting-Sheet loggenBlueprint 5: Content-Pipeline
Notion Trigger (neuer Content-Eintrag mit Status "Draft")
→ Agent: Briefing analysieren, SEO-Keywords extrahieren
→ Web Search: Wettbewerber-Content zu diesem Thema recherchieren
→ Agent: Content-Outline erstellen mit USPs und Keywords
→ Guardrails: Brand Voice + Tonalität prüfen
→ Action: Outline in Notion-Seite schreiben
→ Notification: Content-Manager benachrichtigen
Blueprint 6: Angebotsanfragen qualifizieren
Form Trigger (Angebotsanfrage)
→ Web Search: Firmenprofil recherchieren (Größe, Branche, News)
→ Agent: Lead-Scoring (hot/warm/cold) + Reasoning (Structured Output)
→ Condition: Score prüfen
  ├─ "hot" → Action: Slack-Alert an Senior Sales
  │          → Action: Termin-Link per E-Mail senden
  ├─ "warm" → Action: In Pipeline-Sheet eintragen
  │           → Action: Nurturing-E-Mail senden
  └─ "cold" → Action: Standard-Info per E-Mail senden
→ Action: CRM-Eintrag erstellen
Blueprint 7: Meeting-Vorbereitung
Calendar Trigger (Meeting in 1h)
→ Code: Teilnehmer-E-Mails extrahieren
→ HTTP Request: Kunden-History aus CRM laden
→ File Search: Relevante Dokumente im Knowledge Folder suchen
→ Agent: Meeting-Brief erstellen (Kontext, offene Punkte, Empfehlungen)
→ Action: Brief als Slack-DM an Meeting-Ersteller senden
Blueprint 8: Internes Wissens-FAQ
Slack Trigger (Nachricht in #fragen-an-ki)
→ File Search: Relevante Informationen in Knowledge Folder suchen
→ Condition: Relevante Ergebnisse gefunden? (Score > 0.5)
  ├─ Ja → Agent: Antwort basierend auf Suchergebnissen formulieren
  │       → Action: In Slack-Thread antworten
  └─ Nein → Action: In Slack antworten: "Keine Info gefunden, wird eskaliert"
           → Notification: Wissens-Manager informieren
Blueprint 9: Rechnungs-Verarbeitung mit Approval
Gmail Trigger (neue Rechnung)
→ Agent: Rechnungsdaten extrahieren (Betrag, Lieferant, Fälligkeit)
→ Guardrails: PII-Check
→ Condition: Betrag > 5.000 €?
  ├─ Ja → Human in the Loop: Genehmigung einholen
  │       → Action: Zahlungsanweisung erstellen
  └─ Nein → Action: Zahlungsanweisung direkt erstellen
→ Action: In Buchhaltungs-Sheet eintragen
→ Notification: Bestätigung an Finance-Team
Blueprint 10: Wettbewerbs-Monitoring
Scheduled Trigger (täglich 7:00)
→ Loop über Wettbewerber-Liste
  Variable: competitor
  → Web Search: "{{competitor.name}} News letzte 24h"
  → Delay: 2 Sekunden (Rate Limiting)
→ Agent: Alle Ergebnisse zusammenfassen und nach Relevanz gewichten
→ Condition: Relevante Neuigkeiten gefunden?
  ├─ Ja → Action: Zusammenfassung per Slack an #competitive-intel
  └─ Nein → (nichts tun)
→ Action: Wöchentlichen Report in Google Sheets aktualisierenBest Practices & häufige Stolperfallen
▼Die 10 wichtigsten Best Practices
- Nodes klar benennen. „Feedback analysieren“ statt „Agent 1“. Dein zukünftiges Ich wird es dir danken – und Variablen werden selbsterklärend.
- Ein Workflow = ein Zweck. Halte Workflows fokussiert. Lieber zwei kleine Workflows als einen Monster-Workflow, der alles macht.
- Teste jeden Node einzeln. Nutze den Play-Button auf jedem Node, bevor du weiterbaust. Fehler früh finden spart Zeit.
- Structured Output immer aktivieren. Bei Agent Nodes in Workflows gibt es keinen Grund, darauf zu verzichten. Garantiertes Format verhindert Parsing-Fehler in nachfolgenden Nodes.
- Manual Mode als Standard. Nutze Auto und AI Prompt Mode nur, wenn nötig. Jeder AI-Mode-Aufruf kostet Credits.
- Fehlerbehandlung einplanen. Besonders bei Scheduled Workflows: Füge Notifications hinzu, damit du mitbekommst, wenn etwas schiefgeht.
- Kosten vor Go-Live berechnen. Insbesondere bei Loops und häufigen Triggern kann es schnell teuer werden. Rechne vorher.
- Filter früh, verarbeite spät. Conditions vor teuren Nodes (Agent, HTTP Request) reduzieren unnötige Kosten.
- Draft-Version zum Testen. Veröffentliche erst, wenn alles funktioniert. Die Draft-Version (v0) ist dein Spielplatz.
- Dokumentiere komplexe Logik. Füge Beschreibungen zu Nodes hinzu, besonders bei Code-Nodes und verschachtelter Condition-Logik.
Häufige Stolperfallen
Stolperfalle 1: Auto Mode überall
Auto Mode ist bequem, aber verbraucht bei jedem Run AI Credits. Bei einem Workflow, der 100x am Tag läuft, summiert sich das schnell. Nutze Manual Mode für alles, was statisch ist oder direkt aus Variablen kommt.
Stolperfalle 2: Loop ohne Limit
Ein Loop ohne Max-Iterations-Limit über ein unbekannt großes Array kann zu Kostenexplosion und Timeouts führen. Setze immer ein realistisches Limit.
Stolperfalle 3: Keine Error-Pfade
Wenn ein HTTP Request fehlschlägt und du keinen Error-Pfad definiert hast, stoppt der gesamte Workflow ohne Benachrichtigung. Du merkst es erst, wenn jemand fragt, warum nichts passiert ist.
Stolperfalle 4: Webhook ohne Secret
Ein öffentlich zugänglicher Webhook kann von jedem aufgerufen werden – auch von Bots. In Produktion immer den X-Webhook-Secret-Header nutzen, nicht Query-Parameter (Tokens in URLs landen in Logs und Browser-History).
Stolperfalle 5: Agent-Instruktionen zu vage
„Analysiere diesen Text“ liefert unvorhersagbare Ergebnisse. Sei spezifisch: Was genau soll analysiert werden? Welche Kategorien gibt es? Wie soll das Ergebnis aussehen?
Stolperfalle 6: Scheduled Workflows ohne Monitoring
Ein Workflow, der jeden Morgen um 6:00 Uhr läuft, kann wochenlang fehlschlagen, ohne dass es jemand merkt. Füge immer eine Failure-Notification hinzu.
Stolperfalle 7: Zu große Inputs für Agents
Agents arbeiten am besten mit fokussierten Inputs. Schicke nicht ein 50-seitiges Dokument komplett durch, sondern extrahiere vorher die relevanten Abschnitte (z.B. mit File Search oder Code Node).
Troubleshooting
▼Variable nicht verfügbar
Problem: Die gewünschte Variable erscheint nicht im Autocomplete.
Ursache: Der Node ist nicht verbunden, kommt nach dem aktuellen Node, oder wurde noch nicht getestet.
Lösung: Stelle sicher, dass der Node, der die Variable produziert, vor dem nutzenden Node im Workflow-Graphen kommt. Führe einen Test-Run durch.
Variable ist undefined oder null
Problem: Variable existiert, liefert aber undefined oder null.
Ursache: Der Quell-Node hat fehlgeschlagen, das Feld gibt es nicht, oder optionale Daten wurden nicht bereitgestellt.
Lösung im Code Node:
const email = trigger.output.email || "unbekannt@example.com";
const amount = trigger.output.amount || 0;
Code Node schlägt fehl: Input zu groß
Problem: Der Code Node bricht mit einem Fehler ab, ohne dass der Code ausgeführt wurde.
Ursache: Der kombinierte Input aus den Upstream-Nodes überschreitet das Limit von 5 MiB. Häufigster Auslöser: ein Loop Node mit aktiviertem Collect Outputs über viele Iterationen, oder eine sehr große API-Response.
Lösung: Referenziere im Code nur die Slugs, die du wirklich brauchst, statt die komplette data-Map zu lesen. Reduziere den Upstream-Output durch Filtern oder Zusammenfassen, verarbeite weniger Elemente pro Loop-Iteration, oder schalte Collect Outputs ab.
Node schlägt fehl: Output zu groß
Problem: Der Node läuft durch, bricht aber am Ende ab mit Node output exceeded the maximum size of 25 MB.
Ursache: Jeder Workflow-Node darf maximal 25 MB Output zurückgeben. Typisch bei ungefilterten API-Responses, großen Datenbank-Abfragen oder Loops, die alles einsammeln.
Lösung: Gib nur die Felder zurück, die nachgelagerte Nodes wirklich brauchen. Paginiere große Datensätze, statt sie am Stück durchzureichen. Brauchst du große Inhalte weiter, mach eine Datei daraus – Dateien werden vor der Messung hochgeladen und zählen nicht gegen das Limit.
Agent liefert unerwartete Ergebnisse
Problem: Structured Output hat unerwartete Werte.
Lösung: Prüfe den Output-Tab des Agent Nodes nach dem Test-Run. Schärfe die Instruktionen, füge Beispiele hinzu, und beschränke die möglichen Werte explizit.
Workflow läuft nicht nach Zeitplan
Checkliste:
- Ist der Workflow deployed (nicht Draft)?
- Ist der Workflow aktiv (nicht pausiert)?
- Stimmt die Zeitzone?
- Stimmt der Cron-Ausdruck?
Integration-Trigger oder Action Node reagiert plötzlich nicht mehr
Problem: Ein Workflow mit Integration-Trigger (etwa neue Slack-Nachricht) startet nicht mehr, oder ein Action Node (Mail senden, Sheets-Zeile schreiben) schlägt ohne klaren Fehler fehl.
Ursache: Die Connection der Integration ist nicht mehr gültig. Vier Auslöser kommen infrage:
- Das OAuth-Token ist abgelaufen (je nach Anbieter nach Tagen oder Wochen)
- Der Zugang wurde im Quellsystem widerrufen
- Der Action fehlen Scopes, etwa nach einer Erweiterung des Workflows
- Der zugrunde liegende Custom-OAuth-Client wurde entfernt
Erkennen: Die Connection-Auswahl im Node zeigt eine Warnung mit direktem Link zum erneuten Autorisieren. Zusätzlich sammelt Langdock aktive Workflows mit ungültiger Connection unter Workflows → Monitor im Bereich Workflows to reconnect, und zwar bevor der nächste Lauf daran scheitert. Über Review in der Zeile und dann Reconnect im Dialog bringst du den Zugang wieder in Ordnung, sofern die Connection dir gehört.
Das ist der praktische Unterschied zu früher: Scheduled- und Polling-Workflows liefen bisher still in einen Fehler, weil niemand hinschaut. Der Monitor macht das Problem sichtbar, solange es noch keins ist. Wer produktive Automationen betreibt, sollte diese Liste genauso im Blick behalten wie die offenen Freigaben unter Action required.
Lösung seit Juni 2026: Du kannst Integrationen direkt in den Einstellungen neu authentifizieren, ohne sie zu entfernen und neu hinzuzufügen. Bestehende Workflows, die die Integration nutzen, laufen danach ohne Umbau weiter. Vorher musste die Integration komplett gelöscht und neu verbunden werden.
Integration-Trigger feuert nicht, aber es gibt keinen Fehler
Problem: Ein Workflow mit Integration-Trigger läuft einfach nicht, und in der Run-History steht nichts.
Ursache: Integration-Trigger fragen ihre Quelle in Intervallen ab. Schlug so eine Abfrage fehl, verschwand das früher stillschweigend, es gab weder einen Run noch eine Meldung.
Lösung seit Juli 2026: Fehlgeschlagene Trigger-Polls erscheinen jetzt als fehlgeschlagene Workflow-Runs mit Fehlermeldung in der Run-History. Sieh dort zuerst nach, statt den Workflow neu zu bauen. In den meisten Fällen steckt eine ungültige Connection dahinter.
HTTP Request schlägt fehl
Checkliste:
- Stimmt die URL? (inkl.
https://) - Stimmt die HTTP-Methode?
- Sind Authentication-Headers korrekt?
- Ist das Body-Format valides JSON?
- Tipp: Nutze „Import from cURL“ aus der API-Dokumentation
Fehlgeschlagene Runs erneut starten seit August 2026
Problem: Eine Integration war kurz nicht erreichbar, ein Token ist abgelaufen oder ein Zielsystem hat mit einem Serverfehler geantwortet. Danach stehen zwanzig Läufe auf Failed, obwohl am Workflow selbst nichts kaputt ist.
Lösung: Du musst diese Läufe nicht einzeln nachziehen. In der Run-Historie (Past runs) filterst du auf den Status Failed, wählst bis zu 20 Runs gleichzeitig aus und startest sie gesammelt neu. Zwei Modi stehen zur Wahl:
- Ab dem fehlgeschlagenen Schritt fortsetzen: Bereits erfolgreiche Nodes laufen nicht noch einmal. Der sichere Default, wenn vorgelagerte Nodes E-Mails verschickt, Datensätze angelegt oder Kosten verursacht haben.
- Kompletter Neustart: Der Lauf beginnt wieder beim Trigger, mit den ursprünglichen Trigger-Daten. Sinnvoll, wenn ein früher Node falsche Werte produziert hat.
Welche Version läuft dabei? Das ist der Punkt, an dem in der Praxis die meisten Missverständnisse entstehen. Ab dem fehlgeschlagenen Schritt fortsetzen bleibt auf der Version, mit der der Lauf ursprünglich gestartet ist. Kompletter Neustart nimmt die zuletzt veröffentlichte Version, oder den gespeicherten Draft, wenn noch nichts veröffentlicht ist. Nicht veröffentlichte Änderungen auf der Canvas fließen in keinem der beiden Fälle ein: Wer einen Fix im Draft gebaut hat, muss ihn erst veröffentlichen, sonst wiederholt der Retry denselben Fehler.
Und noch eine Eigenheit: Ein erfolgreicher Retry heilt den alten Lauf nicht. Der bleibt auf Failed stehen und bekommt lediglich einen Successful retry-Chip, der den geglückten Wiederholungslauf benennt und verlinkt. Eine Fehlerstatistik, die nur Status-Werte zählt, sieht deine Aufräumarbeit also nicht.
Sporadische Fehler finden: Run-Historie exportieren seit August 2026
Problem: Ein Workflow scheitert nicht immer, sondern nur manchmal. Im Editor lässt sich das kaum rekonstruieren, weil die Ursache irgendwo zwischen hunderten Läufen liegt.
Lösung: Die Workflow Run Export API gibt Läufe und Node-Ausführungen als JSON heraus, eine Zeile pro Node-Ausführung. Damit zählst du Fehlerquoten pro Node, vergleichst Laufzeiten und findest Muster, die im einzelnen Run unsichtbar bleiben.
curl "https://api.langdock.com/workflows/<workflowId>/runs?from=2026-08-01&to=2026-08-31" \
  -H "Authorization: Bearer <WORKSPACE_API_KEY>"
Jede Zeile bringt run_id, run_number, run_status (PENDING, IN_PROGRESS, AWAITING_INPUT, COMPLETED, FAILED, CANCELLED), workflow_version, trigger_mode (WEBHOOK, FORM, SCHEDULED, INTEGRATION_POLLING, MANUAL), node_type, node_status, failure_code sowie input, output und logs mit. Ein Lauf ganz ohne Node-Ausführungen liefert eine Zeile, in der die Node-Felder null sind. Sortiert wird von alt nach neu.
- Schlüssel: Workspace-API-Key mit dem Scope
WORKFLOW_API(Einstellungen → Workspace → Products → API). Persönliche API-Keys decken nur die Completion-APIs ab und funktionieren hier nicht. - Zugriff: Der Key muss einem Owner oder Editor des Workflows gehören; Workspace-Admins kommen auch ohne Freigabe heran. Die Rolle User reicht nicht, auch nicht für Admins.
- Zeitraum:
fromundtosind Pflicht (ISO 8601), einen Standard-Zeitraum gibt es nicht. Reine Datumsangaben laufen von 00:00:00.000 bis 23:59:59.999 UTC; ein Timestamp ohne Zeitzone wird in der Server-Zeitzone gelesen, gib alsoZoder einen Offset mit. - Grenzen: maximal 10.000 Läufe und 8.000.000 Bytes Payload pro Anfrage, sonst kommt ein
400mitWORKFLOW_RUN_EXPORT_LIMIT_EXCEEDEDbeziehungsweiseWORKFLOW_RUN_EXPORT_TOO_LARGEzurück. Pagination gibt es nicht, die Lösung ist immer ein kleinerer Zeitraum. Rate-Limit: 500 Anfragen pro Minute je Workspace und Key. - Aufbewahrung:
inputundoutputsind nach 30 Tagennull. Wer länger auswerten will, exportiert regelmäßig statt rückwirkend. Einzelwerte über 16.000 Bytes kommen gekürzt, erkennbar am_truncated-Objekt mitoriginalBytes,maxBytesundmessage. - Leere Payloads: Steht
data_redactedauftrue, fehlt dir der Zugriff auf einen beteiligten Node, oft ein Action- oder Agent-Node. Dann ist nicht der Lauf kaputt, sondern die Freigabe. - Was die API nicht liefert: Wer einen Run ausgelöst hat, steht nicht in der Antwort.
workflow_versionmit dem Wert0steht für den Draft, einen Filter nach Test- oder Produktiv-Läufen gibt es über die API nicht.
Auf Dedicated Deployments tritt https://<deine-domain>/api/public an die Stelle von api.langdock.com. Requests direkt aus dem Browser blockt Langdock bewusst, der Export gehört in ein Backend oder ein Skript, nicht in eine Web-App.
Glossar
▼| Begriff | Erklärung |
|---|---|
| Node | Ein einzelner Schritt/Baustein im Workflow |
| Trigger | Der Startpunkt eines Workflows (Form, Webhook, Schedule, Integration, Manual) |
| Connection | Verbindungslinie zwischen Nodes, definiert Ausführungsreihenfolge |
| Variable | Daten, die von einem Node an nachfolgende Nodes weitergegeben werden |
| Structured Output | Definiertes JSON-Schema für Agent-Antworten |
| Field Mode | Art, wie ein Konfigurationsfeld befüllt wird (Auto, Manual, AI Prompt) |
| Guardrail | KI-gestützte Validierungsprüfung für Inhalte |
| Human in the Loop | Manueller Genehmigungsschritt im Workflow |
| Draft (v0) | Entwurfsversion zum Testen, nicht aktiv in Produktion |
| Deploy | Veröffentlichung einer getesteten Version als produktive Version |
| Loop | Iteration über ein Array/eine Liste von Elementen |
| RAG | Retrieval Augmented Generation – KI-Antworten mit Wissens-Suche anreichern |
| Webhook | HTTP-Endpunkt, den externe Systeme aufrufen können |
| Workflow Run Export API | Workspace-API (Scope WORKFLOW_API), die Läufe und Node-Ausführungen eines Workflows als JSON exportiert |
| Rate Limiting | Begrenzung der Anfrage-Häufigkeit an APIs |
| Error Callback | Alternativer Ausführungspfad bei Node-Fehlern |
| Output Node | Endpunkt-Node, der das Workflow-Ergebnis speichert und bei Chat-Integration als Panel anzeigt |
| User Input Node | Pausiert den Lauf für eine Freigabe (Approve/Reject) oder ein Formular (Continue) durch eine Person mit Editor-Zugriff |
| Verschachtelter Workflow | Workflow, der von einem anderen Workflow aufgerufen wird; bis zu fünf Ebenen, mit Zyklus-Erkennung |
| Environment Variable | Einmal definierter Wert, den mehrere Workflows wiederverwenden |
| Transcribe Audio | Node, der Audio im Workflow in Text umwandelt |